Le test de bout en bout vérifie qu’un vrai utilisateur peut accomplir un vrai parcours, comme s’inscrire ou payer une commande, avec tous les systèmes situés derrière l’interface connectés. C’est ce qui en fait la partie du test fonctionnel la plus proche de ce que vivent les clients. Le test d’intégration, à l’inverse, vérifie que deux composants ou plus communiquent correctement à travers leurs interfaces.
Le point de friction se situe dans l’espace entre ces deux définitions. Un cas de test arrive au tableau, l’intégration continue (CI) prend déjà 40 minutes, et la moitié de l’équipe le veut en intégration parce que c’est peu coûteux, tandis que l’autre moitié le veut en test de bout en bout (E2E) parce qu’« il touche à l’interface ». Chaque article sur le test de bout en bout ou le test d’intégration se termine par le même haussement d’épaules : utilisez les deux, suivez la pyramide 70/20/10, bonne chance. Ce conseil ne vous dit rien sur le test que vous avez sous les yeux.
Une meilleure réponse traite chaque placement comme une décision de coût du retour d’information, prise un cas de test à la fois.
Que couvre réellement le test de bout en bout ?
Le test de bout en bout suit un parcours utilisateur complet à travers chaque système qu’il touche. Prenons une commande de chaussures en ligne. Le test ouvre la boutique dans un vrai navigateur, se connecte, ajoute une paire de baskets au panier et applique un code de réduction. Le même test paie ensuite avec une carte de test et vérifie que l’e-mail de confirmation affiche le bon numéro de commande. En chemin, ce seul test sollicite :
- Le frontend : les pages rendues, les formulaires et les boutons, ainsi que l’état conservé par le navigateur comme le panier et la session
- Le backend et les API : les services de tarification, de stock et de commande derrière chaque clic
- La base de données : l’enregistrement de la commande sauvegardé au paiement et relu sur la page de confirmation
- Les services tiers : le prestataire de paiement, le service de messagerie et le fournisseur de connexion
- L’environnement : des réglages proches de la production et des données de test réalistes
Un test de parcours en échec prouve qu’un utilisateur se retrouverait bloqué, mais il montre rarement où se situe la faute. Les tests de plus bas niveau pointent le composant défectueux, c’est pourquoi les équipes exécutent les deux couches.
Le test de bout en bout est souvent confondu avec le test d’acceptation utilisateur, la vérification orientée métier d’une version finalisée. Les deux vérifications suivent des parcours complets, mais des personnes différentes les mènent pour des raisons différentes. Les testeurs scriptent les tests de bout en bout, souvent automatisés, pour trouver les défauts avant la sortie. Les utilisateurs métier mènent les tests d’acceptation pour décider d’accepter ou non la version.
Test de bout en bout, test d’intégration et test système
L’ISTQB, l’organisme international de normalisation du test logiciel, qualifie le test d’intégration et le test système de niveaux de test dans son glossaire, c’est-à-dire des étapes de la construction. Dans ce même glossaire, le test de bout en bout est un type de test dans lequel les processus métier sont testés du début à la fin dans des conditions proches de la production. Cette différence explique pourquoi les termes se recoupent : une vérification de bout en bout peut s’exécuter pendant le test système et répondre malgré tout à sa propre question.
Question clé
Deux composants dialoguent-ils correctement entre eux ?
L’application entière répond-elle à ses exigences ?
Un vrai utilisateur peut-il accomplir un vrai parcours ?
Portée
Une seule interface entre composants ou services
Une application complète, fonctionnalité par fonctionnalité
Un parcours utilisateur complet à travers l’application et les services externes dont elle dépend
Comment il s’exécute
Surtout sous le navigateur, souvent avec les services externes simulés (mockés)
Au regard d’un build complet dans un environnement de test
Dans un vrai navigateur ou sur un vrai appareil, avec des services réels ou en bac à sable (sandbox) connectés
Cadence typique
À chaque commit
Avant chaque sortie
Parcours critiques à chaque fusion, la suite complète la nuit et avant la sortie
Exemple de réinitialisation de mot de passe
Le service de réinitialisation crée un jeton, et le service de messagerie accepte la requête
Chaque fonctionnalité de compte, réinitialisation de mot de passe comprise, fonctionne comme spécifié
Un utilisateur demande une réinitialisation, ouvre l’e-mail, définit un nouveau mot de passe et se connecte
Notre test système vérifie tout un produit au regard de ses exigences, tandis que le test d’intégration couvre les jonctions entre composants et services. Les tests de parcours dépendent des deux couches. Les contrats sous-jacents étant déjà vérifiés, un test de bout en bout en échec pointe vers un vrai problème côté utilisateur.
Au sein d’un seul cas de test, le choix entre test de bout en bout et test d’intégration reste flou. Le filtre de placement à quatre questions, plus bas, tranche ce choix un test à la fois.
Pourquoi les tests de bout en bout doivent rester restreints
Les tests de bout en bout se situent au sommet de la pyramide des tests, un modèle qui place de nombreux tests unitaires rapides à la base, moins de tests d’intégration au milieu, et un petit ensemble de tests de parcours au sommet. Le sommet reste réduit car les tests de parcours sont les plus lents à exécuter et les plus susceptibles de devenir instables (flaky), c’est-à-dire qu’ils réussissent à une exécution et échouent à la suivante sans aucun changement de code. L’instabilité provient généralement du minutage, d’un réseau lent ou d’une réponse tardive d’un service externe.
La recherche pointe vers les mêmes causes profondes : une étude de 2025 portant sur 810 tests instables a révélé que 75 % appartenaient à des grappes partageant une cause profonde, le plus souvent des problèmes réseau et des dépendances externes instables. Ces dépendances sont précisément ce à quoi un test de bout en bout se connecte, si bien que le plan le plus sûr est une petite suite axée sur les parcours critiques pour le chiffre d’affaires. Lorsqu’une suite a déjà dérivé, notre analyse des raisons pour lesquelles les tests deviennent instables (flaky) en détaille les causes habituelles.
La pyramide est une cible de répartition. Elle dit environ 70 % de tests unitaires, 20 % d’intégration, 10 % d’E2E, et s’arrête là. La répartition est le résultat de bonnes décisions de placement test par test, et non quelque chose que l’on atteint en déplaçant les tests d’une couche à l’autre jusqu’à ce que le ratio ait l’air correct. C’est pourquoi le débat entre tests E2E et tests d’intégration ne se règle jamais dans la plupart des équipes : tout le monde débat du ratio, et personne ne s’accorde sur la règle.
Deux modes de défaillance apparaissent lorsque les équipes traitent la pyramide comme un conseil. Le premier est l’embonpoint de l’E2E. Tout ce qui touche à l’interface est poussé vers le haut ; la suite gonfle à 45 minutes ; les développeurs cessent de l’exécuter en local ; et la CI devient un tampon de complaisance. Le second est l’excès de mocks en intégration. Tout ce qui se trouve sous le navigateur est simulé (mocké) pour garder des tests rapides, la suite reste au vert, et la production casse sur un changement de forme d’un webhook Stripe qu’aucun test n’a jamais éprouvé face à la charge utile réelle.
Les deux échecs proviennent de la même cause profonde : personne n’avait de règle pour décider où va un test précis. C’est cette lacune que nous comblons.
Le filtre de placement à quatre questions
Faites passer chaque nouveau cas de test par ces quatre questions, dans l’ordre. Chacune isole une seule décision. Si les réponses pointent vers un vrai navigateur, de vrais services et un parcours lié au chiffre d’affaires, le test gagne une place en E2E. Sinon, il relève de la couche d’intégration, et votre budget CI vous remercie.

Question 1 : sur quelle couche porte l'assertion ?
L’assertion vous indique où va le test. Prenez un test de coupon : « appliquer un code de réduction de 15 % diminue le total du panier ».
Si l’assertion est expect(response.discount).toBe(15), c’est un test d’intégration. Vous vérifiez que le service de tarification a renvoyé le bon nombre. Le navigateur n’a aucune importance. C’est la couche où s’inscrit notre travail de test d’API, et c’est là que devrait vivre l’essentiel de la vérification de la logique métier.
Si l’assertion est expect(page.getByTestId(‘cart-total’)).toHaveText(‘$85.00’), c’est un test E2E. Vous vérifiez que le nombre a atteint le DOM, qu’il a été rendu dans le bon élément et qu’il correspond à ce qu’un utilisateur verrait.
Même logique métier. Deux tests différents. Deux emplacements différents. La règle : la couche de l’assertion décide de la couche du test. Les tests d’intégration qui portent une assertion sur du texte rendu sont des tests d’intégration menteurs. Soit ils ont besoin d’un vrai navigateur (auquel cas ce sont des E2E), soit ils ont besoin d’une autre assertion (auquel cas c’est de l’intégration bien faite).
Question 2 : le tiers est-il le sujet ou la tuyauterie ?
Chaque parcours de paiement dépend de services externes. Stripe, Twilio, Auth0, SendGrid. La question est de savoir si le tiers est ce que vous testez ou simplement quelque chose que le test touche au passage.
Prenez un test de carte refusée : « une carte Stripe refusée affiche l’écran de nouvelle tentative ».
Si vous vérifiez que les codes de refus de Stripe correspondent correctement à votre taxonomie d’erreurs interne, Stripe est le sujet. C’est un test d’intégration face au mode test de Stripe ou à une fixture enregistrée. Ce qui vous importe, c’est de savoir si card_declined devient PaymentFailedError.RetryableDecline de votre côté.
Si vous vérifiez que l’utilisateur voit un bouton de nouvelle tentative, peut ressaisir les détails de sa carte et obtient un nouvel essai, Stripe est la tuyauterie. L’interface de nouvelle tentative est le sujet. C’est un test E2E.
L’erreur que commettent les équipes est de pousser vers l’E2E tout ce qui touche à un tiers parce qu’« il faut le vrai service ». Non. Il ne faut le vrai service que lorsque c’est sur le service que porte votre assertion. Tout le reste peut simuler la tuyauterie et tester le véritable sujet au niveau le moins coûteux.
Question 3 : un changement de contrat suffirait-il à casser ce test ?
Prenez un test d’e-mail : « l’e-mail de confirmation de commande contient l’identifiant de commande ».
Si un service en aval renomme orderId en order_id et que ce test casse alors que l’utilisateur reçoit toujours le bon e-mail avec le bon identifiant, vous avez un test de contrat déguisé en test E2E. Le journal d’échec dira « champ attendu orderId, obtenu order_id ». C’est un échec d’intégration, et c’est en intégration qu’il devrait apparaître : rapide, peu coûteux, et pointant directement vers le contrat rompu.
Les tests E2E devraient échouer sur le comportement, c’est-à-dire que l’utilisateur a obtenu le mauvais résultat. Lorsqu’ils échouent sur la forme, c’est-à-dire qu’un champ de la charge utile est renommé alors que l’expérience utilisateur est identique, le coût de débogage est multiplié par environ 10, car vous traquez une différence de JSON à travers une trace de navigateur, des captures d’écran et des journaux réseau. Les échecs de contrat relèvent de la couche d’intégration et se vérifient à l’aide d’assertions de schéma ou d’un outil de test de contrat.
Question 4 : parcours critique pour le chiffre d'affaires ou branche secondaire ?
Tous les parcours d’utilisateur réels ne méritent pas un test E2E. Prenez un test de paramètres : « l’utilisateur fait passer ses préférences de notification d’un résumé hebdomadaire à un résumé quotidien ».
Vrai parcours. Vraie écriture en base de données. Vrai impact utilisateur. Il relève malgré tout de la couche d’intégration. Chaque test E2E que vous ajoutez taxe chaque future pull request, et cette taxe s’accumule. Réservez les places en E2E aux parcours où une défaillance est un événement pour le chiffre d’affaires : inscription, connexion, paiement, règlement, montée en gamme d’abonnement, récupération de compte. Tout le reste mérite une couverture d’intégration, sauf s’il existe un risque de rendu d’interface précis que seul un navigateur peut attraper.
Le test d’intégration ou le test de bout en bout est une décision de coût du retour d’information. Dépensez votre budget E2E là où une défaillance vous coûterait un client.
Des tests promus en E2E qui n’auraient pas dû l’être
C’est la catégorie de gaspillage la plus courante dans une suite E2E surchargée. Chacun de ces tests a une signature d’échec précise : le test échoue, et le correctif est un changement d’une seule ligne dans du code qui n’a jamais eu besoin d’un navigateur pour être vérifié.
- Tests de validation de formulaire. « Le champ e-mail rejette les chaînes sans @ ». Cela relève de la couche d’intégration et devrait être testé face au validateur. Si cela vit en E2E, vous payez le coût de lancement d’un navigateur pour tester une expression régulière.
- Tests de mise en correspondance d’erreurs d’API. « Une erreur 500 du service de paiement affiche “réessayez plus tard”. » Test d’intégration au niveau du gestionnaire d’erreurs. Ce n’est pas le navigateur qui met l’erreur en correspondance.
- Tests de persistance en base de données. « Un formulaire de contact soumis apparaît dans le panneau d’administration. » Deux tests d’intégration, un pour l’écriture et un pour la lecture, valent mieux qu’un seul E2E instable qui couvre les deux et prend 30 secondes par exécution.
- Tests de drapeaux de fonctionnalité (feature flags). « Les utilisateurs avec le drapeau X voient la variante B. » Test d’intégration au niveau de la couche de résolution des drapeaux. E2E seulement si la variante visuelle elle-même comporte un risque.
- Tests de permissions. « Un utilisateur non administrateur ne peut pas accéder à /admin. » Test d’intégration au niveau de l’intermédiaire d’authentification. Chaque route restreinte enveloppée dans un E2E est une suite que vous élaguerez dans six mois.
Diagnostic que vous pouvez mener dans votre propre équipe cette semaine : récupérez les cinq derniers échecs E2E. Si chacun était corrigeable en regardant une réponse réseau plutôt qu’une capture d’écran, votre suite a dérivé vers le bas. La moitié relève de la couche d’intégration, et l’horloge de la CI en est le reçu.
Des tests rétrogradés en intégration qui ont cassé la production
L’erreur inverse est plus rare, plus coûteuse, et passe généralement inaperçue jusqu’à ce qu’un client ouvre un ticket. Un test descendu en intégration pour la vitesse ; des mocks remplaçant les vrais services ; tout reste au vert ; la production casse sur ce que les mocks dissimulaient précisément.
Les parcours en plusieurs étapes dont l’état est conservé dans le navigateur en sont le cas classique. Persistance du panier d’une page à l’autre, assistants en plusieurs étapes, paiement basé sur la session. Lorsque vous simulez la couche de session, vous simulez aussi la disparition du bug qui part en production. Les redirections vers des tiers en sont un autre. Rappels OAuth, Stripe Checkout, passage de relais PayPal. L’aller-retour de redirection est là où les choses cassent, et il n’existe pas dans un test d’intégration. Le comportement dépendant du CSS relève lui aussi de l’E2E : un bouton d’envoi caché derrière une fenêtre modale parce qu’un z-index a changé lors de la sortie de mardi n’apparaîtra à aucune couche située sous un vrai navigateur. Le comportement des cookies inter-origines, les changements de SameSite et l’authentification par iframe tombent tous dans le même panier.
La règle : si le bug n’apparaît que dans un vrai navigateur dialoguant avec de vrais services, l’intégration ne peut pas le prendre en charge, aussi complets que soient les mocks. Les systèmes distribués intensifient ce schéma, c’est pourquoi nous le traitons à part dans notre article sur le test de performance des microservices.
La séparation nette
Deux énoncés de responsabilité résument tout l’article. L’intégration prend en charge :
- La communication de service à service et la forme de ce qui franchit la frontière
- Les vérifications de contrat : noms de champs, types, codes d’erreur, schémas de réponse
- La logique métier sous le navigateur : validation, mise en correspondance d’erreurs, permissions, résolution des drapeaux de fonctionnalité, lectures et écritures en base de données
- Tout test où le tiers est le sujet de l’assertion
- Tout test où une défaillance apparaîtrait comme « mauvaise réponse du service » plutôt que « mauvaise chose à l’écran »
L’E2E prend en charge :
- La sortie rendue : la bonne chose à l’écran, au bon endroit, au bon moment
- Les parcours en plusieurs étapes dont l’état est porté par le navigateur
- Les redirections et allers-retours vers des tiers (rappels OAuth, Stripe Checkout, passage de relais PayPal)
- Le comportement dépendant du CSS et du DOM (fenêtres modales, z-index, boutons cachés, cookies inter-origines)
- Les parcours critiques pour le chiffre d’affaires où une défaillance signifie un client perdu
Résumé en une ligne : l’intégration prouve que les pièces communiquent correctement ; l’E2E prouve que l’utilisateur va au bout. Si un test tente de faire les deux, séparez-le en deux.
Maintenant, la règle de placement est un outil opérationnel. Faites passer n’importe quel test par les quatre questions. Si la Q1 répond « sortie rendue », la Q2 répond « sujet » et la Q4 répond « critique pour le chiffre d’affaires », le test gagne sa place en E2E. Sinon, par défaut, direction l’intégration. Le choix du framework vient ensuite et compte moins que ne le pensent la plupart des équipes. Que votre équipe utilise Cypress, Playwright ou Selenium, la discipline est en place, et notre page sur le test automatisé explique comment nous le rendons opérationnel de bout en bout.
Quand faut-il exécuter les tests de bout en bout ?
Même une suite restreinte a besoin d’un calendrier, car exécuter chaque test de bout en bout à chaque changement bloque le pipeline. La plupart des équipes répartissent les exécutions par déclencheur :
- À chaque fusion : un ensemble de tests de fumée portant sur les parcours les plus critiques, qui s’achève en quelques minutes et confirme que le build fonctionne globalement. Notre comparaison entre test de fumée et test de santé explique en quoi ces deux vérifications rapides diffèrent.
- La nuit : la suite complète au regard du dernier build, avec les résultats dans la messagerie de l’équipe au matin. Cette exécution nocturne ancre généralement le test de régression, qui confirme que le nouveau code n’a pas cassé les anciennes fonctionnalités.
- Avant une sortie : la suite complète sur le build candidat à la sortie, sur les navigateurs et appareils dont disposent vos utilisateurs.
- Après le déploiement : quelques parcours clés exécutés périodiquement contre le produit en service. Cette pratique, appelée surveillance synthétique, attrape les défaillances de configuration et de tiers qu’aucun environnement de test ne reproduit.
- Après un changement de tiers : une exécution supplémentaire lorsqu’un prestataire de paiement, de messagerie ou de connexion modifie son API, car de tels changements cassent des parcours sans toucher à votre code.
Les outils modernes de test E2E : Playwright, Cypress et Selenium
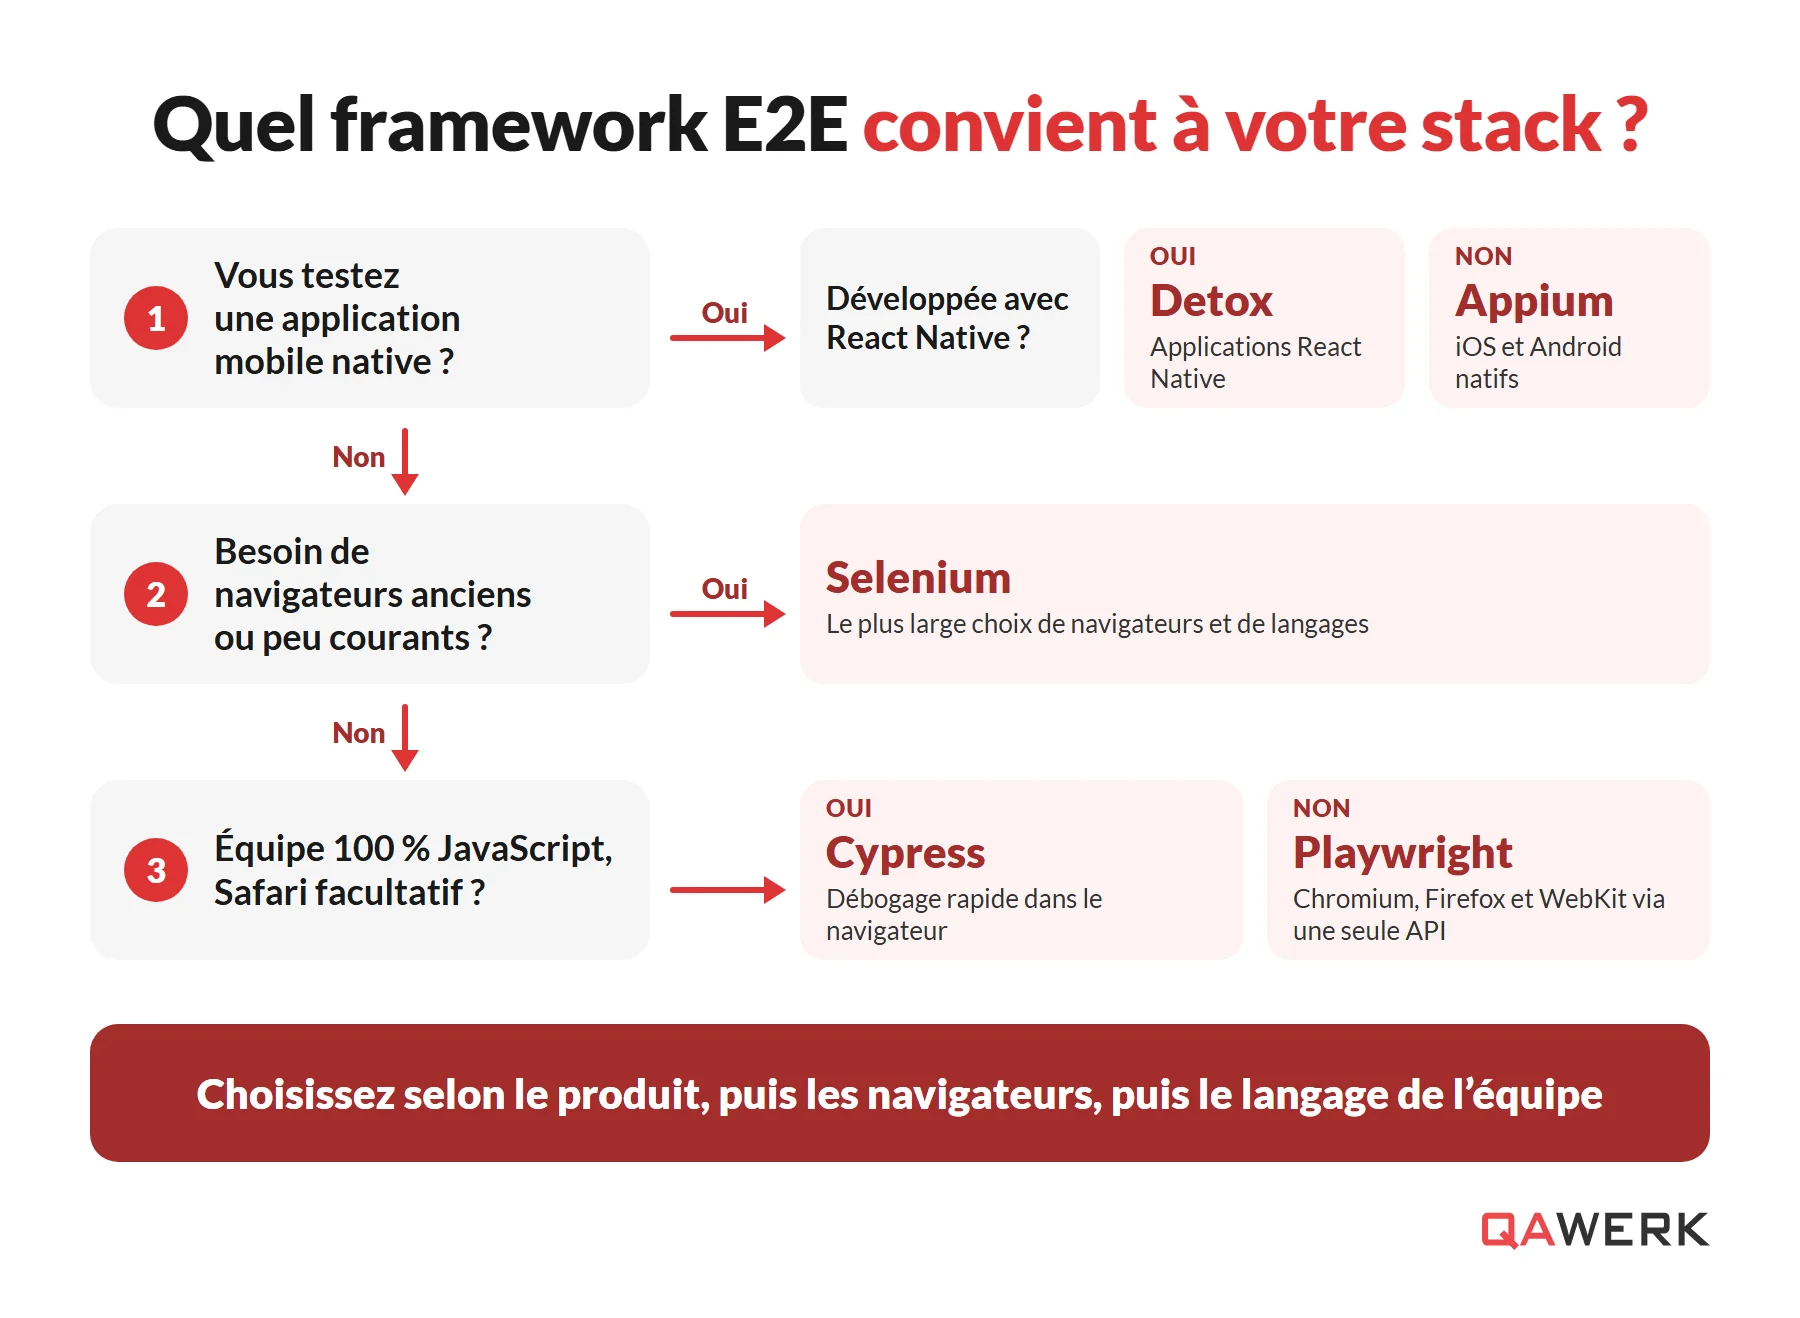
Lorsque les équipes comparent les outils de test E2E pour applications web, la liste restreinte se réduit généralement à Playwright, Cypress et Selenium :
- Playwright : le framework open source de Microsoft pilote Chromium, Firefox et WebKit, le moteur derrière Safari, depuis une seule API. Playwright prend en charge TypeScript, JavaScript, Python, Java et .NET, si bien qu’une seule suite peut servir des équipes aux piles techniques différentes.
- Cypress : Cypress s’exécute à l’intérieur du navigateur, ce qui rend le débogage rapide et visuel. Le framework convient aux équipes JavaScript qui testent des applications web modernes.
- Selenium : Selenium prend en charge le plus large éventail de navigateurs et de langages de programmation, si bien qu’il reste courant dans les configurations héritées et les grandes bases de code Java ou C#. Le projet migre aussi vers WebDriver BiDi, une norme W3C plus récente pour l’automatisation des navigateurs.
Les deux frameworks les plus récents utilisent désormais l’IA pour réduire la maintenance. Les test agents de Playwright planifient les tests, les génèrent et réparent ceux qui échouent. Cypress propose cy.prompt, qui transforme des étapes de test rédigées en anglais courant en commandes Cypress. L’outillage par IA abaisse le coût d’écriture des tests, mais c’est toujours une personne qui décide quels parcours méritent un test.
Les suites de bout en bout s’exécutent généralement sur plusieurs navigateurs et tailles d’écran, et c’est là que le travail E2E recoupe le test multi-navigateurs. Les applications mobiles natives nécessitent leurs propres outils, généralement Appium pour iOS et Android, ou Detox pour les applications React Native.
Comment QAwerk mène le test de bout en bout
Chaque mission de bout en bout commence par la même question : qu’est-ce qui mérite un test de parcours ? À partir de là, notre processus se déroule en cinq étapes :
- Cartographier les parcours critiques. Avec le product owner, nous énumérons les parcours où une défaillance coûte du chiffre d’affaires ou de la confiance, et convenons de ce qui reste hors périmètre.
- Choisir le framework adapté à la pile technique. Nous choisissons Playwright, Cypress ou Selenium pour le web et Appium pour le mobile natif, selon vos langages, vos navigateurs et votre CI.
- Isoler les données de test. Chaque test crée ses propres données et fait le ménage ensuite, afin qu’aucune exécution ne dépende d’une autre.
- Répartir les exécutions par déclencheur. Les tests de fumée s’exécutent à chaque commit, la suite complète s’exécute la nuit, et les résultats arrivent dans votre Slack.
- Garder certaines vérifications manuelles. Les parcours qui dépendent de boîtes de réception externes ou d’interactions instables comme le glisser-déposer coûtent plus cher à automatiser qu’ils ne font économiser.
Voici comment cela s’est concrétisé sur trois projets :
- Une pharmacie en ligne : pour Dr.Ansay, nous avons construit plus de 40 tests Playwright autour des parcours utilisateur les plus essentiels et les avons exécutés quotidiennement. Nos tests ont attrapé un panier qui se vidait après la connexion et un code promo qui poussait le total à -53,20 €. Le client a ensuite constaté 18 % de paniers abandonnés en moins.
- Une boutique e-commerce durable : les 284 tests automatisés de Kazidomi prenaient environ 6 heures à s’exécuter, nous en avons donc extrait un groupe de fumée d’environ 30 qui s’exécutait après chaque commit.
- Une startup d’API d’émission de cartes : pour Union54, nous avons migré la suite vers Cypress pour ses nouvelles tentatives automatiques, qui absorbent les brèves pannes de tiers. Une exécution nocturne complète de 1 500 scénarios prend environ 1 h 30.
Parce que nos ingénieurs se joignent à vous comme un prolongement de votre équipe, nous pouvons intervenir à n’importe quelle étape, d’un projet sans aucun test automatisé à une suite en laquelle personne n’a confiance.
Où chaque test gagne sa place
La différence entre le test d’intégration et le test E2E n’est pas une question de taxonomie. C’est une décision test par test qui façonne l’horloge de votre CI, votre taux d’incidents en production et la confiance de votre équipe dans la suite. Quatre questions, appliquées de manière cohérente, remplacent la dispute-par-test par une règle que toute l’équipe peut partager.
Si votre suite a dérivé, si la CI prend 40 minutes là où elle en prenait 8, ou si la production casse sans cesse sur des choses que vos tests d’intégration disaient correctes, nous auditerons où vos tests se trouvent réellement par rapport à où ils devraient être.
Réservez un audit de votre suite de tests.
FAQ
Qu’est-ce que le test de bout en bout ?
Le test de bout en bout vérifie qu’un utilisateur peut accomplir un parcours complet, comme s’inscrire ou passer une commande, à travers l’interface réelle. Le backend, la base de données et les services tiers restent connectés de bout en bout. Comme ces tests sont lents et peuvent être instables, les équipes les réservent aux parcours critiques et testent les règles métier à des niveaux plus rapides.
Quelle est la différence entre le test d'intégration et le test de bout en bout ?
Le test d’intégration vérifie que deux composants ou plus communiquent correctement à travers leurs interfaces. Le test de bout en bout vérifie qu’un utilisateur peut accomplir un parcours à travers l’interface réelle avec de vrais services connectés. La différence pratique tient à l’endroit où se situe l’assertion : dans une réponse de service ou dans ce que voit un utilisateur.
Comment décider si un cas de test relève de l'intégration ou de l'E2E ?
Demandez-vous ce que vérifie l’assertion. S’il s’agit d’une réponse de service, d’un contrat ou d’une forme de données, cela relève de la couche d’intégration ; s’il s’agit d’un élément rendu ou d’un parcours utilisateur en plusieurs étapes, cela relève de l’E2E. Tout test qui réussirait encore avec une interface cassée n’est pas un test E2E.
Quand le test d'intégration suffit-il, et quand faut-il de l'E2E ?
L’intégration suffit lorsque le tiers est le sujet du test, lorsqu’une défaillance apparaîtrait comme une mauvaise réponse de service, ou lorsque le parcours se situe hors du chemin du chiffre d’affaires. Il vous faut de l’E2E lorsque le navigateur transporte l’état d’une étape à l’autre, lorsque des redirections vers des tiers sont en jeu, ou lorsqu’une défaillance signifie un client perdu à l’inscription, au paiement ou au règlement.
Pourquoi ma suite de tests E2E est-elle trop lente ?
Des tests qui relèvent de la couche d’intégration ont été poussés vers le haut : la validation de formulaire, la mise en correspondance d’erreurs, les vérifications de permissions et la résolution des drapeaux de fonctionnalité ont rarement besoin d’un vrai navigateur. Auditez les cinq derniers échecs E2E de votre projet ; si chacun était corrigeable avec une réponse réseau plutôt qu’une capture d’écran, la majeure partie de votre suite est au mauvais endroit.
Découvrez comment QAwerk a stabilisé les intégrations de paiement et de règlement et amélioré la couverture de régression pour Kazidomi avant son expansion à travers l'Europe.