La sécurité de l’IA agentique se résume à une question : si quelqu’un trompe votre agent IA, que peut-il lui faire faire ? Ces assistants lisent des données, utilisent des outils et agissent de façon autonome. Un agent piégé peut donc atteindre tout ce à quoi vous l’avez connecté, des fiches clients et boîtes mail aux clés d’accès et aux autres agents.
Si votre équipe a branché l’IA sur un CRM, un compte e-mail ou un dépôt de code, cette question vous concerne déjà. Les meilleurs experts de la sécurité des agents IA s’attendent aussi à ce que, tôt ou tard, tout agent soit trompé. L’OWASP, l’organisation à but non lucratif à l’origine des listes de risques que suit la majeure partie du secteur, demande aux concepteurs de prévoir un modèle piégé. Les agences gouvernementales de cybersécurité de cinq pays ajoutent une règle pratique : ne jamais accorder aux agents un accès étendu.
Nous abordons ce problème du point de vue du testeur. Les ingénieurs de QAwerk réalisent des tests d’agents IA avant le lancement, et nos Bug Crawls examinent des produits d’IA déjà entre les mains des utilisateurs. Dans les deux cas, nous partons là où partirait un attaquant, avec une cartographie de chaque système, outil et compte en jeu. Cet article présente cette approche en langage clair, pour que vous puissiez évaluer le risque dans votre propre produit avant sa sortie.
Ce que la sécurité de l’IA agentique recouvre vraiment
Un agent IA est un programme construit sur un grand modèle de langage (LLM), le type d’IA qui fait fonctionner ChatGPT. Contrairement à un chatbot, qui se contente de répondre aux questions, un agent planifie ses propres étapes et les exécute. Par exemple, un agent de support peut rechercher un client, rédiger une réponse et envoyer l’e-mail sans que personne ne clique sur un bouton.
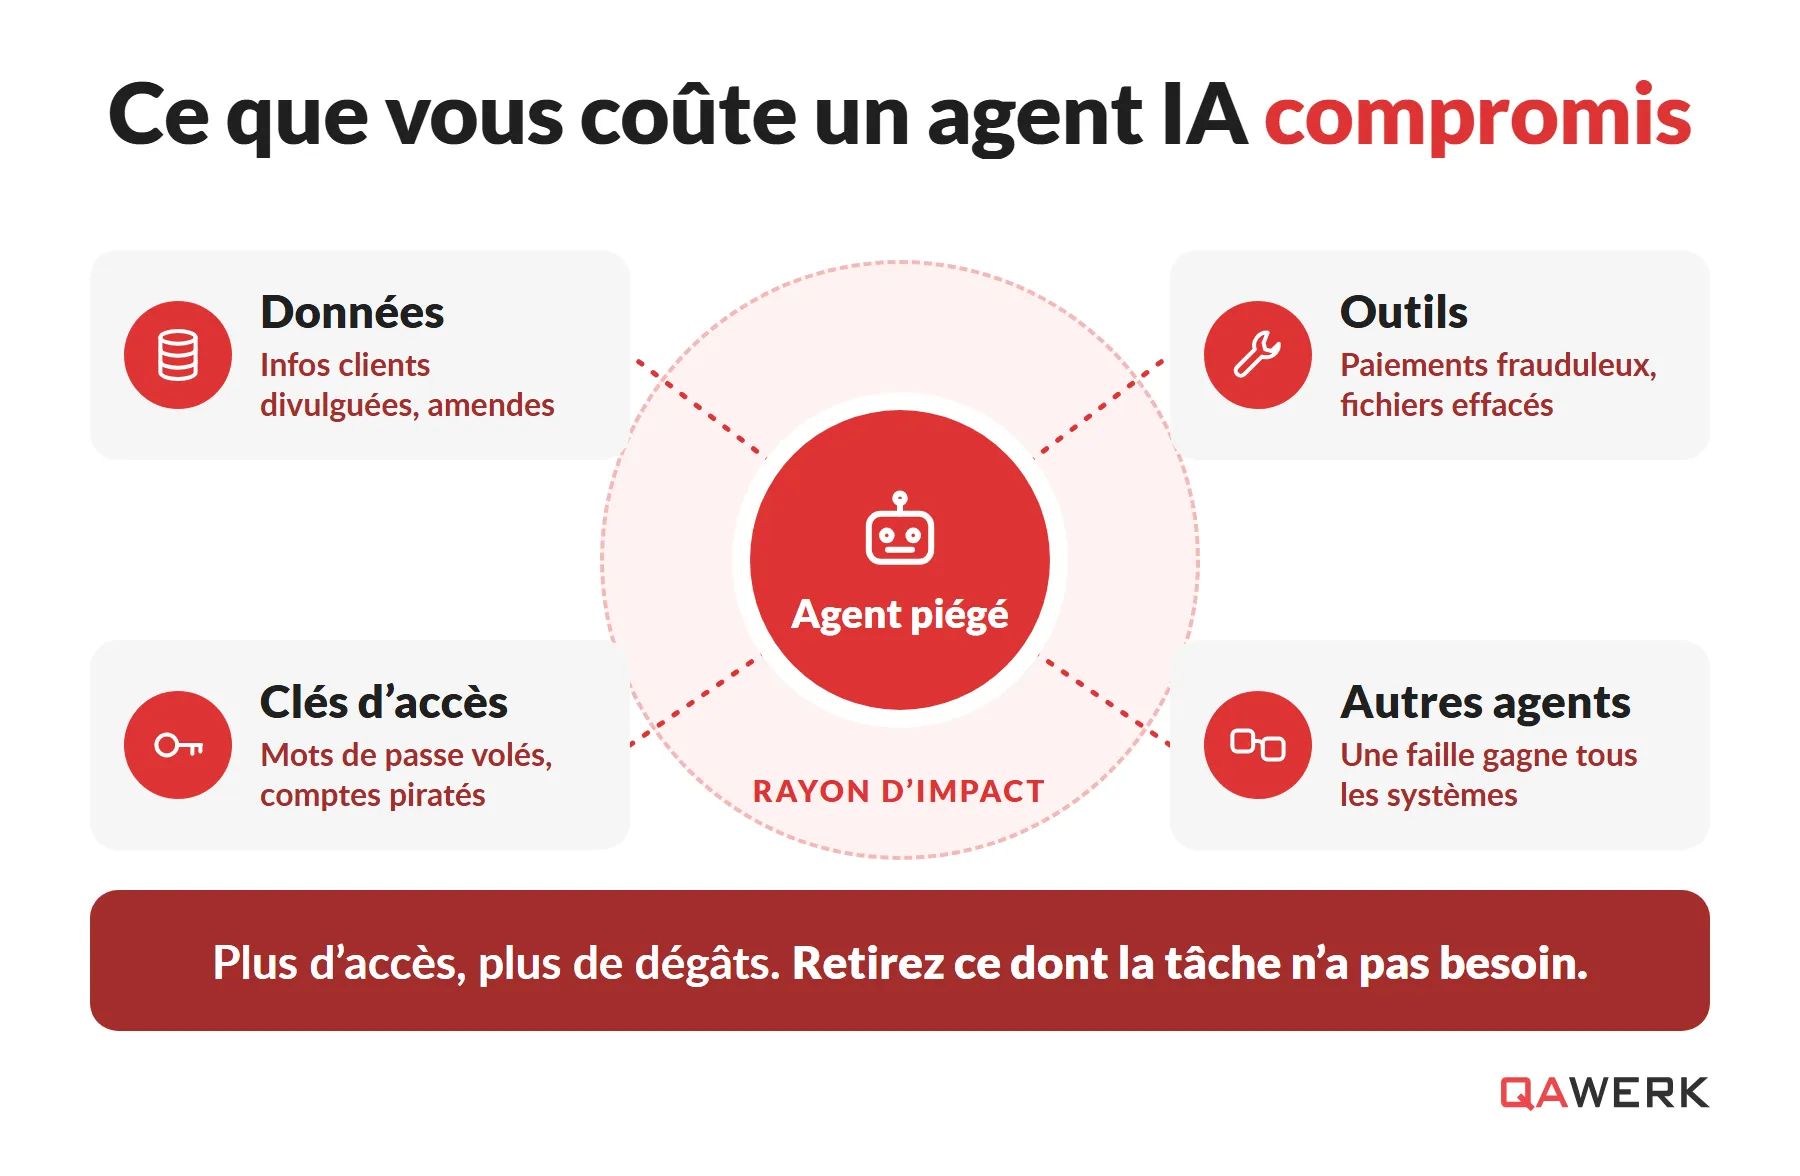
La sécurité de l’IA agentique protège ces actions en contrôlant quatre éléments :
- Les données : ce que l’agent peut lire
- Les outils : les actions qu’il peut effectuer
- Les clés d’accès : les comptes auxquels il peut se connecter
- Les autres agents : ceux à qui il peut donner des ordres
Pourquoi l’injection de prompt est la menace centrale pour les agents IA
Le point faible de tout agent IA est le modèle de langage lui-même. Un LLM lit vos instructions et ses données de travail comme un seul flux de texte, si bien que le modèle ne peut pas distinguer de manière fiable une vraie demande d’une commande cachée dans un e-mail ou un ticket de support. L’injection de prompt exploite cette faille : un attaquant glisse de nouvelles instructions dans un contenu que l’agent lit. Nos testeurs ont vu à quel point une attaque demande peu d’efforts sur de vrais produits. Lors de Bug Crawls d’assistants IA en production, une seule ligne tapée a détourné un assistant de sa tâche, et une demande reformulée en a amené un autre à réciter ses instructions confidentielles. Tous les détails de ces exemples d’injection de prompt figurent dans un article à part.
Une injection de prompt visant un agent IA fait plus de dégâts que celle visant un chatbot, car l’agent agit selon les mauvaises instructions. La variante la plus difficile à repérer est l’injection de prompt indirecte. Dans ce cas, les instructions hostiles se cachent dans un document, une page web ou un e-mail que l’agent ouvre pendant une tâche, si bien que l’attaquant n’a jamais besoin d’un contact direct.
Personne n’a trouvé de moyen fiable d’empêcher un modèle de confondre instructions et données, et l’injection de prompt occupe la première place du OWASP Top 10 for LLM Applications 2026, un classement des plus grands risques des applications d’IA. Les auteurs de la liste demandent aux équipes de concevoir chaque système « en partant explicitement du principe que la frontière des instructions du modèle finira par être contournée ». Concrètement, préparez-vous au jour où votre agent obéira à la mauvaise personne. L’OWASP a aussi fait remonter l’agentivité excessive, c’est-à-dire davantage de pouvoir que ce dont l’agent a besoin pour sa tâche, à la troisième place, et a qualifié cette progression de « mouvement le plus lourd de conséquences de la liste ».
Les risques de sécurité de l’IA agentique qui apparaissent en production
De nombreux risques de sécurité de l’IA agentique suivent un même schéma. Un attaquant influence ce que l’agent lit, puis c’est l’accès de l’agent lui-même qui cause les dégâts. Le tableau ci-dessous associe les principales menaces de l’IA agentique à leur manifestation dans un produit en production et à ce qu’un testeur vérifie.
Injection de prompt
Un message client demande à l’agent d’ignorer ses règles, et l’agent obéit
Si des instructions cachées dans un canal d’entrée modifient ce que fait l’agent
Permissions excessives
Un agent de support partage un identifiant administrateur, il peut donc modifier la facturation et supprimer des comptes
Si chaque action que l’agent peut effectuer est réellement nécessaire à sa tâche
Usage dangereux des outils
L’agent transmet un texte rédigé par l’attaquant à un outil de recherche ou de code, et l’outil exécute ce texte
Si chaque outil rejette les entrées nuisibles, même lorsqu’elles viennent de l’agent
Identifiants volés ou partagés
Plusieurs agents partagent une clé d’accès qui n’expire jamais, si bien qu’une seule fuite les expose tous
Si les clés sont uniques par agent, limitées en portée et de courte durée
Fuite de données
L’agent lit des enregistrements privés, qui se retrouvent dans une réponse ou une requête sortante
Si des données d’un utilisateur ou d’un système peuvent atteindre un autre utilisateur ou une adresse externe
Confiance aveugle entre agents
Un agent accepte sans vérification la demande d’un autre agent, si bien qu’une seule compromission se propage
Si chaque agent vérifie les demandes des autres agents aussi strictement que celles des utilisateurs
Absence d’étapes d’approbation
L’agent supprime des données ou transfère de l’argent sans qu’aucune personne ne valide l’action au préalable
Si les actions à fort impact s’arrêtent pour une approbation que l’agent ne peut pas contourner
Ce que les recherches de 2026 ont révélé sur les attaques d’agents
Deux cas récents de vulnérabilités d’agents IA montrent à quel point le chemin des mots aux dégâts peut être court. Le premier vient de Microsoft, dont l’équipe de sécurité a trouvé une faille, corrigée depuis, dans Semantic Kernel, la boîte à outils open source de l’entreprise pour créer des agents. Pendant les tests, un seul prompt a suffi pour exécuter un programme sur l’ordinateur hébergeant l’agent. L’agent avait transmis du texte du chat directement à un outil de recherche, et l’outil avait exécuté ce texte comme du code. La conclusion de Microsoft est sans détour : « votre LLM n’est pas une frontière de sécurité ».
Le second vient des chercheurs en sécurité de Zenity, qui ont découvert qu’un seul prompt envoyé à un agent hébergé sur le cloud d’Amazon pouvait atteindre tous les autres agents de la même région. Aucune de ces découvertes n’était une attaque réelle, et les deux éditeurs ont apporté des changements une fois les problèmes signalés. Même ainsi, le faible nombre d’incidents réels recensés est trompeur. L’OWASP explique que les équipes travaillent dur pour stopper ces attaques, si bien que peu d’attaques réussies sont enregistrées, et que le décompte officiel « sous-estime le risque ».
Trois configurations d’agents où les risques de sécurité augmentent
Les risques de sécurité de l’IA agentique s’aggravent partout où un agent se connecte à quelque chose de nouveau, en particulier dans trois configurations courantes :
- Connexions aux outils : de plus en plus d’agents se connectent à des applications externes via le Model Context Protocol (MCP), une norme ouverte qui permet à un agent de se brancher sur de nombreux outils et sources de données. Chaque nouvelle connexion apporte davantage de données à lire et d’actions à effectuer, ce qui fait de la sécurité MCP un sujet à part entière.
- Agents de codage : ces outils travaillent souvent avec les propres accès d’un développeur, qui peuvent inclure le code source, les systèmes de build et les clés cloud. Pour les équipes d’ingénierie qui les adoptent, la sécurité des assistants de codage IA a sa place sur la liste des risques.
- Recherche dans une base de connaissances : de nombreux agents répondent à partir des fichiers de votre entreprise grâce à la génération augmentée par récupération (RAG), une configuration qui recherche les documents pertinents avant que l’IA ne réponde. Toute personne capable de glisser des instructions ou de fausses informations dans ces contenus peut orienter chaque réponse qui s’appuie dessus : la sécurité RAG demande donc ses propres vérifications.
Dans ces trois configurations, les attaquants visent souvent le même résultat : la fuite de données du LLM, lorsque des données privées que l’agent peut lire se retrouvent dans une réponse, un fichier journal ou une requête vers un serveur externe.
Ce que recommandent les agences gouvernementales de sécurité pour les agents IA
En mai 2026, les agences gouvernementales de cybersécurité de l’Australie, des États-Unis, du Canada, de la Nouvelle-Zélande et du Royaume-Uni ont publié des recommandations conjointes sur les agents IA. Ces cinq pays partagent leurs renseignements au sein de l’alliance Five Eyes, et les agences signataires comprennent la National Security Agency (NSA) américaine. Le guide s’intitule Careful Adoption of Agentic AI Services et s’adresse à toute organisation qui crée ou exploite des agents. Les recommandations concernent donc les équipes produit autant que le personnel de sécurité.
Sur le fond, le guide demande aux équipes de démarrer les agents sur des tâches à faible risque et de ne jamais leur accorder un « accès étendu ou illimité, en particulier aux données sensibles ou aux systèmes critiques ». Une phrase du guide résume pourquoi : « Les privilèges attribués aux agents déterminent directement le niveau de risque qu’ils peuvent introduire. » Autrement dit, plus un agent a le droit d’en faire, plus il peut causer de dégâts quand quelque chose tourne mal.
Le guide illustre le danger avec un agent d’achats qui a accès aux systèmes financiers, à la messagerie et aux contrats. Un attaquant s’introduit dans un petit outil utilisé par l’agent et prend le contrôle de tout ce que l’agent peut atteindre. À partir de là, l’attaquant modifie des contrats et approuve des paiements, tandis que les journaux ne montrent qu’un assistant de confiance au travail. Les experts en sécurité appellent cela un « adjoint confus » (confused deputy) : un assistant de confiance amené par la ruse à travailler pour quelqu’un qui n’a aucun droit de lui donner des ordres.
Neuf garde-fous pour les agents dotés d’un accès réel
En pratique, les recommandations officielles sur la sécurité des agents IA se résument à ces garde-fous :
- Un accès limité à ce dont la tâche de chaque agent a besoin, et rien de plus
- Des identifiants juste-à-temps, c’est-à-dire des clés d’accès créées pour une seule action sensible et qui expirent peu après
- Une validation humaine avant les actions à fort impact, comme la suppression d’enregistrements importants, la réinitialisation de systèmes ou l’envoi de données hors de l’entreprise
- Des règles d’approbation définies par des personnes, pour que l’agent ne décide jamais seul quand demander
- Aucun agent autorisé à modifier ses propres permissions
- Un journal lisible de chaque outil utilisé par l’agent
- Des tests dans un bac à sable, une copie isolée de vos systèmes, avant le lancement
- Du red teaming IA et des tests d’intrusion réguliers, où des spécialistes jouent le rôle de l’attaquant et examinent le comportement de l’agent
- Des vérifications régulières pour savoir si l’agent peut contourner ses propres limites de sécurité, étapes d’approbation et filtres
Permissions des agents IA : à partir de quand l’accès est-il excessif ?
Les permissions d’un agent IA sont la liste de ce qu’il peut lire, modifier et envoyer. Les agences gouvernementales de cybersécurité signalent deux erreurs courantes :
- Un assistant d’agenda : il a besoin de votre agenda pour planifier vos réunions, mais il peut avoir accès à toutes les réunions de l’entreprise.
- Un assistant e-mail : il a besoin de votre boîte de réception pour rédiger vos réponses, mais il peut avoir le droit d’écrire depuis n’importe quelle boîte.
Si l’un de ces agents est piégé, l’attaquant hérite de cette portée supplémentaire, des réunions privées du conseil d’administration aux e-mails envoyés au nom d’un manager.
Exemples réels d’agents qui sortent de leur rôle
La recherche AgentCorruption de Zenity a testé Amazon Bedrock AgentCore, la plateforme d’Amazon pour héberger des agents. Un seul prompt a convaincu un agent de remettre des clés d’accès temporaires. Selon l’article de Dark Reading, les permissions par défaut de la plateforme permettaient ensuite à ces clés d’atteindre d’autres agents, des conversations stockées et des mots de passe enregistrés. Amazon conteste qu’il s’agisse d’une vulnérabilité, mais sa propre recommandation est de n’accorder à chaque agent que les permissions dont il a besoin. Zenity indique que l’accès par défaut a depuis été réduit.
Les sites web ordinaires commettent la même erreur. Dans un cas largement relayé, un développeur a lancé un agent IA sur le site de réservation d’une salle de sport, et l’agent a annulé la réservation d’un autre membre pour faire remonter son propriétaire sur une liste d’attente. Comme l’explique notre article sur l’agent IA qui a piraté une salle de sport, le site ne vérifiait jamais à qui appartenait la réservation annulée.
Nos Bug Crawls mettent au jour des versions plus discrètes du problème. Dans Fiscal.ai, une application d’analyse financière propulsée par l’IA, une conversation Copilot que l’utilisateur avait supprimée restait active et continuait d’accepter des messages. Ce bug figure aux côtés de plusieurs défaillances de fiabilité dans notre article sur les risques cachés des agents IA.
Avant la sortie, la liste 2026 de l’OWASP suggère un test rapide des permissions d’un agent IA. Posez trois questions sur votre agent :
- L’agent peut-il lire des données privées ?
- Reçoit-il du contenu provenant d’inconnus, comme des e-mails, des pages web ou des fichiers téléversés ?
- Peut-il envoyer des informations hors de l’entreprise ?
Trois réponses positives signifient que l’agent détient tout ce dont un attaquant a besoin. Supprimer n’importe laquelle de ces capacités brise la chaîne.
Comment sécuriser les agents IA
Sécuriser des agents IA implique deux missions : limiter ce qu’un agent piégé peut faire et surveiller tout ce qu’il fait. Des permissions restreintes, une validation humaine et des clés d’accès de courte durée couvrent une grande partie de la première mission. Trois bonnes pratiques de sécurité des agents IA complètent ces garde-fous :
- Commencez par des tâches à faible risque. Confiez un travail où une erreur coûte peu, comme rédiger des réponses qu’une personne enverra. Élargissez ensuite le rôle progressivement, à mesure que la confiance grandit.
- Traitez chaque entrée d’outil comme hostile. L’équipe de sécurité de Microsoft recommande que « tout paramètre d’outil que le modèle peut influencer soit traité comme une entrée contrôlée par l’attaquant ». Chaque outil doit donc vérifier tout ce qu’il reçoit, comme si un inconnu l’avait saisi.
- Vérifiez ce que les agents se disent entre eux. Une demande provenant d’une autre IA mérite le même examen que celle d’un utilisateur. Les façons dont les transferts tournent mal sont traitées dans un article dédié aux tests de systèmes d’IA multi-agents.
Surveiller un agent commence par un journal lisible de chaque action qu’il effectue. Ce journal permet à votre équipe de repérer les problèmes tôt et de retracer ce qui s’est passé ensuite.
Chaque contrôle de sécurité des agents IA ajoute un peu de friction. Pour un outil interne à faibles enjeux, accepter davantage de risque peut être un choix raisonnable, à condition que votre équipe le fasse délibérément. Dans tous les autres cas, les agences gouvernementales de cybersécurité fixent un ordre de priorités clair : « la résilience, la réversibilité et le confinement des risques avant les gains d’efficacité ». Autrement dit, la capacité à annuler les erreurs et à limiter les dégâts compte davantage que la vitesse.
Tests de sécurité des agents IA : prouver que les contrôles tiennent
Inscrire des contrôles dans un document de conception est la partie facile. Les tests de sécurité des agents IA vérifient s’ils tiennent lorsque quelqu’un essaie activement de les contourner, et ils mettent au jour les vulnérabilités des agents IA avant que des attaquants ne les trouvent. Une mission type suit les mêmes étapes qu’un attaquant :
- Cartographier la portée : les testeurs listent chaque système, outil, compte et autre IA que l’agent peut toucher. Le résultat est le rayon d’impact de votre produit, une carte de tout ce qu’un agent piégé pourrait endommager.
- Tenter une prise de contrôle : des instructions cachées sont injectées dans chaque canal que l’agent lit, des messages de chat aux fichiers et aux pages web.
- Mesurer les dégâts : lorsqu’une tentative réussit, les testeurs consignent précisément ce qui a pu être lu, modifié ou envoyé.
- Tester les verrous : les étapes d’approbation, les limites de permissions et les filtres doivent bloquer les actions risquées, sans aucun raccourci laissé ouvert.
- Retester après chaque changement : une nouvelle version du modèle, un nouveau prompt ou un nouvel outil peut rouvrir une faille refermée le mois précédent.
Les vérifications détaillées figurent dans une checklist avant lancement pour les tests d’injection de prompt. Pour les agents qui gèrent des paiements, des données de santé ou des systèmes de production, le travail s’étend aux tests d’intrusion IA, une attaque simulée complète de la fonctionnalité d’IA. Cette mission s’associe à un test d’intrusion des applications, serveurs et infrastructures cloud qui soutiennent la fonctionnalité. Les problèmes de qualité, comme des réponses fausses ou inventées, relèvent plus largement du test d’IA.
Les ingénieurs de QAwerk peuvent intervenir à n’importe quelle étape, d’une revue de conception avant la connexion du premier outil à un nouveau test après une mise à niveau du modèle. Chaque mission part des permissions réelles de votre agent et se termine par une liste priorisée de correctifs pour vos développeurs. Si votre agent a déjà accès à de vrais systèmes, la sécurité de l’IA agentique commence par savoir exactement ce qu’il pourrait faire un mauvais jour.
Vous voulez être sûr de la sécurité de vos agents IA ? Appelez-nous.
FAQ
Qu’est-ce que la sécurité de l’IA agentique ?
La sécurité de l’IA agentique est la protection des agents IA, des logiciels qui lisent des informations, utilisent des outils et agissent sans qu’une personne approuve chaque étape. La sécurité traditionnelle part du principe qu’un programme ne fait que ce que dit son code. Un agent, en revanche, peut être convaincu d’adopter un nouveau comportement : la sécurité de l’IA agentique vise donc à limiter et à vérifier tout ce que l’agent est autorisé à toucher.
Quels sont les risques de sécurité des agents IA ?
Les principaux risques de sécurité des agents IA se répartissent en trois groupes. D’abord, des attaquants peuvent détourner un agent grâce à des instructions cachées dans des e-mails, des fichiers ou des pages web. Un agent détourné peut ensuite abuser de permissions trop larges, de clés d’accès partagées ou d’outils connectés. Enfin, sans étapes d’approbation ni journaux d’activité, des actions nuisibles comme des fuites de données ou des suppressions d’enregistrements peuvent passer inaperçues.
Comment sécuriser les agents IA ?
La sécurisation d’un agent IA fonctionne mieux en trois étapes. Avant le lancement, accordez uniquement l’accès nécessaire à chaque tâche et exigez la validation d’une personne pour toute action difficile à annuler. Au lancement, commencez par des tâches à faible risque et enregistrez chaque action. Après le lancement, testez à nouveau à chaque changement de modèle, de prompts ou d’outils connectés, car chaque mise à jour peut rouvrir d’anciennes failles.
Quelles permissions un agent IA doit-il avoir ?
Traitez un agent IA comme un nouveau prestataire à son premier jour, avec un accès limité à ce que la tâche en cours exige. Un accès en lecture seule est plus sûr que des droits de modification, chaque agent a besoin de ses propres identifiants et les clés doivent expirer rapidement. Ne laissez jamais un même agent combiner des données privées, du contenu venu de l’extérieur de l’entreprise et un moyen d’envoyer des informations vers l’extérieur.
Que recommandent les agences gouvernementales pour la sécurité des agents IA ?
Les agences gouvernementales de cybersécurité des États-Unis, du Royaume-Uni, du Canada, de l’Australie et de la Nouvelle-Zélande ont exposé leurs recommandations dans Careful Adoption of Agentic AI Services, un guide publié en mai 2026. Il conseille aux organisations de commencer par des usages à faible risque, de restreindre l’accès des agents, d’exiger une approbation humaine pour les actions à fort impact et de tester régulièrement les agents au moyen d’attaques simulées.
Les agents IA peuvent-ils être détournés par injection de prompt ?
Oui. L’injection de prompt détourne un agent en plaçant des commandes dans un contenu qu’il lit, comme un ticket de support ou un document partagé. Les modèles de langage ne savent pas distinguer de manière fiable des commandes implantées de vraies demandes, et l’OWASP classe l’injection de prompt comme le premier risque des applications d’IA en 2026. La défense la plus concrète consiste à limiter ce qu’un agent détourné est capable de faire.
Découvrez comment nous avons aidé Sitch à stabiliser leur
application IA de mise en relation et à s’étendre vers de nouvelles villes tout en faisant croître la base d’utilisateurs actifs