Si votre équipe modifie un prompt, change de modèle ou redécoupe une base de connaissances, quelqu’un doit décider si ce changement peut partir en production. Sans cadre d’évaluation des LLM, cette décision repose sur quelques vérifications manuelles ponctuelles et sur l’avis de la dernière personne à avoir regardé les sorties, ce qui tient pour une démo et cède à la première mise à niveau du modèle.
En bref : définissez ce que « bon » signifie pour chaque cas d’usage, rassemblez de 50 à 200 exemples réels avec le comportement attendu, notez-les avec un mélange de contrôles par code, de juges LLM calibrés et de revue humaine, et bloquez toute release qui passe sous les seuils convenus. Une première version opérationnelle représente généralement une à deux semaines de travail pour un ingénieur. Ensuite, le coût récurrent se résume surtout aux appels API du modèle juge, plus quelques heures de revue humaine par mois. Ce guide détaille les six étapes, puis compare huit outils qui les exécutent. Si vous préférez que nous construisions et fassions tourner ce cadre pour vous, c’est ce que couvrent nos services d’évaluation des LLM.
Qu’est-ce qu’un cadre d’évaluation des LLM
Un cadre d’évaluation des LLM est le processus reproductible qu’une équipe utilise pour prouver qu’une fonctionnalité LLM est assez bonne pour être mise en production : les objectifs de qualité, un golden dataset (jeu de données de référence), les métriques, les évaluateurs qui les notent, les seuils de validation et un calendrier d’exécution pour l’ensemble. Des bibliothèques comme DeepEval et Ragas sont les outils qui exécutent ce processus.
Le terme « framework » désigne deux choses différentes, et c’est en les confondant que des équipes se retrouvent avec un outil installé et aucune stratégie d’évaluation. Votre cadre, c’est l’ensemble des décisions : quels comportements comptent, comment vous les mesurez et quel score bloque une release. Une bibliothèque de framework est du code qui exécute ces décisions pour vous, avec des implémentations de métriques, des exécuteurs de tests et des tableaux de bord. Vous pouvez changer de bibliothèque plus tard et conserver chacune de ces décisions.
Les tests individuels à l’intérieur du cadre sont généralement appelés LLM evals. Une eval peut vérifier qu’un bot de support ne promet jamais un montant de remboursement ; une autre note si un résumé reste fidèle au document source.
Composants clés d’un cadre d’évaluation des LLM
Tout cadre qui fonctionne comporte les six mêmes composants, quel que soit l’outil qui l’exécute. Les objectifs et les jeux de données définissent ce que vous testez, les métriques et les évaluateurs définissent comment chaque sortie est notée, et les seuils et la cadence d’exécution décident de ce qu’il advient du score. Retirez-en un et les autres perdent l’essentiel de leur valeur : une métrique bien choisie sans seuil produit un chiffre sur lequel personne n’agit, et un seuil vérifié seulement avant le lancement passe à côté de toutes les régressions qui suivent. Le tableau présente les six composants pour un assistant de support client.
Objectifs d’évaluation
Que doit réussir cette fonctionnalité, et que ne doit-elle jamais faire ?
Les réponses sur les remboursements citent la politique en vigueur et ne promettent jamais de montant précis
Jeux de données
Quelles entrées le prouvent ?
150 tickets réels anonymisés avec les réponses attendues, plus 30 prompts adverses
Métriques
Comment chaque objectif est-il mesuré ?
Faithfulness par rapport au document de politique, answer relevancy, validité du schéma JSON, refus corrects
Évaluateurs
Qui ou quoi attribue les notes ?
Assertions de code pour le format, un juge LLM pour la faithfulness, un relecteur humain pour le ton
Seuils
Quel score suffit pour mettre en production ?
Faithfulness d’au moins 0,9 sur les questions de remboursement, zéro échec de schéma
Cadence d’exécution
Quand s’exécute-t-il ?
Un sous-ensemble rapide à chaque pull request, le jeu complet chaque nuit, un échantillon hebdomadaire du trafic de production
Les évaluateurs méritent qu’on s’y attarde, car c’est là que se concentrent l’essentiel des coûts et la plupart des problèmes de confiance :
- Les contrôles par code (regex, validation de schéma, correspondance exacte, « a-t-il appelé la bonne fonction ») sont peu coûteux, déterministes et d’une portée limitée. Utilisez-les pour tout ce qui n’a qu’une seule bonne réponse.
- LLM-as-a-judge note à grande échelle des qualités subjectives comme la faithfulness (fidélité à la source), l’utilité ou le ton. Chaque note coûte un appel API, et sa fiabilité ne vaut que ce que vaut sa calibration.
- Les relecteurs humains servent de point de référence. Trop lents pour noter chaque exécution, ils ont pour rôle principal d’étiqueter le jeu de calibration et d’examiner les cas sur lesquels les évaluateurs automatisés ne sont pas d’accord.
Comment construire un cadre d’évaluation des LLM en 6 étapes
Ces six étapes vous font passer de « on regarde les sorties à l’œil » à un cadre qui conditionne les releases. L’ordre compte : des métriques choisies avant de définir les cas d’usage finissent souvent par mesurer ce que l’outil rend facile à mesurer.
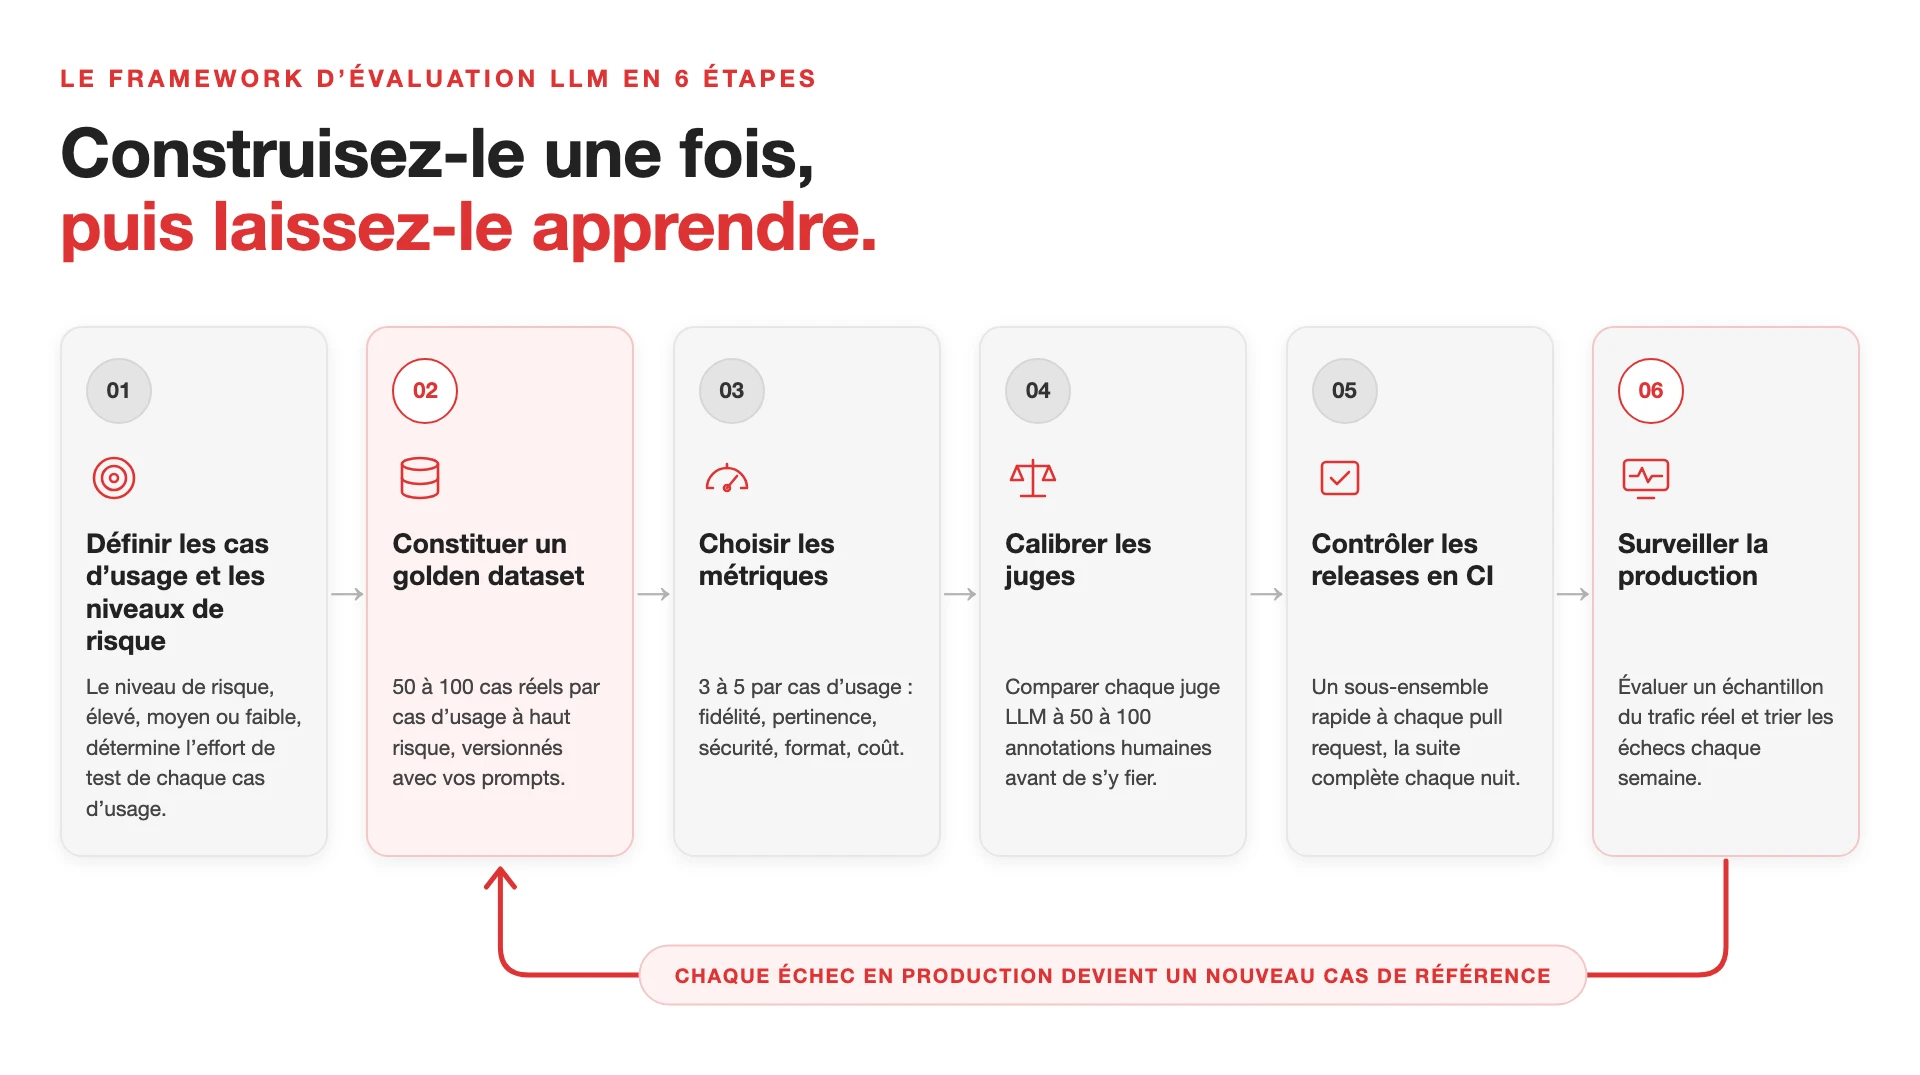
Étape 1 : définir les cas d’usage et les niveaux de risque
Listez chaque tâche distincte que le LLM accomplit dans votre produit. Un assistant de support peut répondre à des questions de politique, résumer un ticket pour un agent et rédiger une réponse, et chacune de ces tâches échoue différemment. Attribuez ensuite un niveau de risque à chaque cas d’usage, car c’est ce niveau qui détermine l’effort d’évaluation qu’il mérite.
Élevé
Agit, conseille ou s’engage au nom de l’utilisateur
Appels d’outils qui écrivent des données, conseils financiers ou médicaux, modifications de compte
Le plus grand jeu de données, des seuils stricts, une revue humaine d’un échantillon à chaque release
Moyen
Informe directement un client
Réponses du support, recherche produit, aide à l’onboarding
Jeu de données solide, gates automatisés, vérifications humaines ponctuelles et périodiques
Faible
Assiste un utilisateur interne qui la relit
Rédaction interne, résumés de tickets pour le personnel
Jeu de données plus petit, gates plus légers
Pour chaque cas d’usage, rédigez deux listes courtes : ce qu’une bonne réponse doit faire, et ce qu’elle ne doit jamais faire. Ces listes deviennent vos objectifs d’évaluation.
Étape 2 : constituer un golden dataset
Un golden dataset est un ensemble versionné d’entrées, chacune associée au comportement attendu. C’est l’actif le plus précieux du cadre, car chaque métrique et chaque outil que vous ajouterez ensuite s’exécute dessus.
Les bonnes sources, à peu près par ordre de valeur :
- Les logs de production et les tickets de support anonymisés, qui montrent ce que les vrais utilisateurs demandent réellement
- Des cas rédigés par des experts métier pour des situations rares mais coûteuses
- Des cas adverses et des cas limites : tentatives de prompt injection, questions hors périmètre, demandes ambiguës, autres langues
- Des exemples synthétiques générés par un LLM pour combler les lacunes, chacun relu par une personne avant d’intégrer le jeu
Commencez avec de 50 à 100 exemples par cas d’usage à risque élevé, puis enrichissez le jeu à partir de là. Chaque enregistrement doit contenir l’entrée, le contexte récupéré le cas échéant (pour la génération augmentée par récupération, ou RAG), la sortie attendue ou une grille de notation, et des tags comme l’intention, la langue et la difficulté. Ce sont ces tags qui vous permettront ensuite de voir les résultats par segment. Stockez le jeu de données dans votre gestionnaire de versions, à côté de vos prompts, pour que chaque résultat d’évaluation puisse être rattaché à la version exacte du jeu de données qui l’a produit.
Étape 3 : choisir les métriques
Associez chaque objectif d’évaluation issu de l’étape des cas d’usage à une métrique qui le mesure. La plupart des produits ont besoin de trois à cinq métriques par cas d’usage, choisies dans ces groupes :
- Exactitude et ancrage : faithfulness, hallucination rate (taux d’hallucination), answer relevancy (pertinence de la réponse) et, pour le RAG, context precision (précision du contexte) et context recall (rappel du contexte)
- Réussite de la tâche : task completion (accomplissement de la tâche) et, pour les agents, tool-call correctness (exactitude des appels d’outils)
- Sécurité : toxicité, fuite de données personnelles, refus corrects, résistance à la prompt injection
- Format : validité du schéma, limites de longueur, présence des champs obligatoires
- Opérationnel : latence et coût par réponse, suivis à côté de la qualité pour qu’un prompt « meilleur » qui triple le coût reste visible
Notre analyse des métriques d’évaluation des LLM explique comment chacune est calculée et dans quels cas elle induit en erreur.
Les agents demandent une couche supplémentaire. Une réponse finale correcte peut masquer un mauvais cheminement : le mauvais outil appelé en premier, une boucle de nouvelles tentatives, une action d’écriture qui n’aurait jamais dû s’exécuter. Notez la trajectoire autant que le résultat ; notre guide des métriques d’évaluation des agents IA le détaille étape par étape.
Comment nous avons défini les métriques pour Granola. Pour Granola, un bloc-notes IA qui transforme l’audio des réunions et des notes brutes en résumés structurés, nous avons évalué la sortie du LLM sur l’exactitude factuelle, les hallucinations et sa capacité à conserver le bon contexte au fil de conversations complexes à plusieurs tours. Comme les notes générées diffèrent à chaque exécution, des contrôles par correspondance exacte ne pouvaient pas les noter : nous avons donc utilisé des LLM dans nos scripts d’automatisation pour vérifier les résumés, avec notamment DeepEval parmi les outils, et exécuté la suite en CI. La configuration complète est décrite dans notre étude de cas sur l’automatisation des tests pour Granola.
Étape 4 : choisir les évaluateurs et calibrer les juges
Utilisez un contrôle déterministe partout où il en existe un. Ne recourez à un juge LLM que pour les qualités que le code ne peut pas noter, et considérez chaque juge comme non fiable tant qu’il n’a pas été calibré par rapport à des humains.
Une routine de calibration concrète :
- Prenez de 50 à 100 sorties de votre golden dataset et faites-les étiqueter indépendamment par deux personnes selon la grille de notation.
- Tranchez les cas où les deux personnes ne sont pas d’accord. Si elles divergent souvent, la grille est ambiguë : corrigez-la avant de faire intervenir un modèle.
- Exécutez le juge LLM sur les mêmes sorties et mesurez à quelle fréquence il concorde avec les étiquettes humaines.
- Ajustez le prompt du juge (critères plus clairs, exemples commentés, échelle plus resserrée) jusqu’à obtenir un niveau de concordance acceptable pour ce niveau de risque.
- Recalibrez chaque fois que vous changez de modèle juge, de grille ou de domaine produit.
Quelques habitudes rendent les juges plus fiables. Un verdict binaire réussite/échec ou une échelle à trois points se calibre plus facilement qu’une note sur dix. Demander au juge de rédiger son raisonnement avant le verdict améliore la cohérence. Figez la version du modèle juge pour que les scores restent comparables dans le temps et, si possible, utilisez une famille de modèles différente de celle du modèle évalué, car les modèles ont tendance à juger favorablement leur propre style. Dans les comparaisons par paires, exécutez chaque paire dans les deux ordres pour neutraliser le biais de position.
Étape 5 : intégrer les évaluations à la CI et définir des gates
Une évaluation que quelqu’un doit penser à lancer finira par ne plus être lancée. Intégrez-la au pipeline :
- À chaque pull request qui touche un prompt, un paramètre de modèle, une configuration de récupération ou une définition d’outil, exécutez un sous-ensemble rapide du golden dataset qui se termine en quelques minutes.
- Chaque nuit ou avant chaque release, exécutez le jeu de données complet avec toutes les métriques.
Décidez ensuite de ce qui bloque un merge. Les gates stricts sont des contrôles à tolérance zéro : échecs de schéma, échecs de sécurité, appel d’outil à risque élevé effectué sans confirmation. Les gates souples comparent les métriques de qualité à la référence actuelle de production et échouent dès qu’un segment recule au-delà d’une marge convenue. Comparer à une référence fonctionne mieux que des cibles absolues fixes, car la sortie d’un LLM varie d’une exécution à l’autre. Réduisez ce bruit en fixant la température quand le produit le permet, ou en échantillonnant chaque cas plusieurs fois et en notant la moyenne.
C’est le cœur des tests de régression des LLM : chaque changement est jugé par rapport à la dernière version connue comme bonne, segment par segment.
Prévoyez un budget pour les appels au juge. Une exécution complète de 200 cas avec trois métriques jugées représente 600 appels au juge, si bien qu’une suite nocturne plus les exécutions sur pull request finissent par peser sur un mois. Les contrôles par code ne coûtent rien, une raison de plus de les utiliser en premier.
Étape 6 : surveiller la production et réinjecter les échecs dans le jeu de données
L’évaluation avant release ne couvre que les entrées auxquelles vous avez pensé, la surveillance de la production doit donc attraper le reste. Tracez chaque appel au LLM (entrée, contexte récupéré, appels d’outils, sortie, latence, coût), exécutez vos juges sur un échantillon du trafic réel et surveillez les signaux utilisateurs comme les pouces vers le bas, les escalades vers un humain et les sessions abandonnées.
Une fois par semaine, triez les échecs. Chaque échec réel qui révèle un nouveau cas de figure devient un nouveau cas du golden dataset, ce qui signifie que la release suivante sera automatiquement testée dessus. Faire tourner cette boucle en continu, avec un responsable, une cadence et des alertes de dérive, c’est la pratique qu’on appelle l’EvalOps.
Meilleurs cadres et outils d’évaluation des LLM
Une fois les six étapes définies, c’est un outil qui les exécute. Le marché se divise entre des bibliothèques open source que vous exploitez vous-même et des plateformes managées qui ajoutent le traçage, des tableaux de bord et des files de revue. Beaucoup d’équipes finissent avec un outil de chaque type : une bibliothèque pour les tests en CI et une plateforme pour les traces de production.
DeepEval
Open source (Apache 2.0), plus la plateforme Confident AI
Équipes Python qui veulent écrire leurs evals comme des tests
Oui, métriques intégrées
Oui, métriques de task completion, de tool correctness et de plan
Oui, deepeval test run
Ragas
Open source (Apache 2.0)
Produits centrés sur le RAG, ou métriques RAG au sein d’un autre outil
Oui, c’est son cœur de métier
Partiel, tool-call accuracy et goal accuracy
Oui, modèle pytest
Promptfoo
Open source (MIT), plus des offres Enterprise payantes
Comparer prompts et modèles, red teaming, toute stack technique
Oui, assertions sur le contexte
Oui, assertions sur la trajectoire
Oui, GitHub Action officielle
LangSmith
Plateforme managée, auto-hébergement avec l’offre Enterprise
Équipes qui développent sur LangChain ou LangGraph
Oui, évaluateurs basés sur des juges
Oui, correspondance de trajectoire
Oui, pytest et Vitest/Jest
Langfuse
Open source (cœur sous MIT), plus un cloud managé
Traçage et evals sur votre propre infrastructure
Oui, via l’intégration Ragas et des juges
Oui, basé sur les traces
Oui, GitHub Action
OpenAI Evals
Dépôt open source (MIT, maintenance uniquement) ; fermeture de la version hébergée le 30 novembre 2026
Configurations existantes à migrer
Non intégré
Non intégré
Dépôt uniquement
Arize Phoenix
Code source disponible (Elastic License 2.0), plus la plateforme Arize AX
Traçage auto-hébergé avec evals intégrées
Oui, pertinence de la récupération et des réponses
Oui, sélection et invocation d’outils
Oui, pytest et Vitest/Jest
Braintrust
Plateforme managée, plus les scorers open source autoevals
Ingénieurs et product managers qui examinent les expériences ensemble
Oui, scorers RAG d’autoevals
Oui, scorers de spans et de traces
Oui, GitHub Action avec commentaires sur les PR
Si votre produit est avant tout un pipeline de récupération, notre comparatif des outils d’évaluation RAG va plus loin que ce guide général sur la notation propre à la récupération.
Comment choisir le bon cadre d’évaluation des LLM pour votre équipe
Partez de trois contraintes : votre stack, la taille de votre équipe et les endroits où vos données ont le droit d’aller. Votre stack détermine le travail d’intégration qu’un outil exige, puisqu’une bibliothèque adaptée à votre langage et à votre runner de CI peut conditionner vos pull requests en quelques jours. La taille de l’équipe détermine si une plateforme hébergée est rentable, et la résidence des données élimine souvent des options avant même toute comparaison de fonctionnalités.
Équipe Python qui veut des evals sous forme de tests en CI
DeepEval
Langfuse ou Phoenix pour les traces de production
Produit principalement basé sur la récupération (RAG)
Métriques Ragas, exécutées via DeepEval ou Langfuse
Une plateforme de traçage pour l’échantillonnage en direct
Comparaisons fréquentes de prompts et de modèles, tous langages
Promptfoo
Une plateforme de traçage pour la production
Application construite sur LangChain ou LangGraph
LangSmith
agentevals pour les trajectoires d’agents
Les données doivent rester sur votre propre infrastructure
Langfuse ou Phoenix, auto-hébergé
DeepEval ou Promptfoo en CI
Ingénieurs et product managers examinent les résultats ensemble
Braintrust ou LangSmith
Contrôles par code en CI pour les gates stricts
Actuellement sur la version hébergée d’OpenAI Evals
Promptfoo, conformément aux recommandations de migration d’OpenAI
Traçage pour la production
Selon la taille de l’équipe. Avec un ou deux ingénieurs, le plus efficace est une seule bibliothèque open source en CI et un tableur d’étiquettes humaines ; à ce stade, une plateforme ajoute surtout de la configuration. Les équipes d’environ cinq à vingt personnes ajoutent généralement une plateforme de traçage dès que le trafic de production devient significatif, car l’échantillonnage manuel du trafic réel ne passe plus à l’échelle. Les organisations plus grandes ou réglementées ont besoin d’un contrôle d’accès par rôle, de pistes d’audit et souvent d’auto-hébergement, ce qui les oriente vers les offres Enterprise ou l’open source auto-hébergé.
Selon la résidence des données. Si les prompts ou les sorties contiennent des données personnelles, financières ou de santé, vérifiez tôt si les traces peuvent quitter votre infrastructure. Langfuse et Phoenix s’auto-hébergent dans leurs versions gratuites ; LangSmith, Braintrust et la plateforme Confident AI ne proposent l’auto-hébergement que dans leurs offres Enterprise. Les modèles juges comptent aussi : un juge LLM envoie chaque sortie notée à son fournisseur, donc un tableau de bord auto-hébergé ne suffit pas à lui seul à garder les données en interne.
Quand vous n’avez pas besoin de plateforme. Si vous avez une seule fonctionnalité LLM, un trafic modeste et une équipe qui vit déjà dans la CI, une bibliothèque et un golden dataset dans git couvrent l’essentiel de ce qu’apporterait une plateforme. Ajoutez une plateforme quand l’échantillonnage de la production, les files de revue ou l’accès pour des profils non techniques deviennent de vrais besoins.
Le choix de l’outil est aussi plus réversible qu’il n’y paraît, à condition que le golden dataset, les grilles de notation et les seuils vivent dans votre dépôt dans un format simple. Ces éléments se transposent à n’importe quel outil ; les tableaux de bord et les traces stockées, en général, non.
Erreurs courantes dans l’évaluation des LLM
1. Évaluer une seule fois. Une évaluation faite la semaine du lancement ne couvre que la version de lancement, et la prochaine modification de prompt, la prochaine mise à jour du modèle par le fournisseur ou les nouveaux documents ajoutés à la base de connaissances le mois dernier peuvent chacun annuler ce résultat. Une évaluation qui n’est ni dans la CI ni appliquée à un échantillon de la production devient obsolète en quelques semaines.
2. Faire confiance à un juge non calibré. Un juge LLM produit des scores assurés et d’apparence cohérente, qu’ils correspondent ou non au jugement humain. Sans la routine de calibration décrite à l’étape consacrée aux juges, une équipe peut optimiser un prompt pendant des mois vers un chiffre qui ne reflète pas ce que vivent les utilisateurs.
3. Laisser les moyennes masquer les segments en échec. Imaginons une faithfulness globale de 0,92. Cette moyenne peut inclure un segment en espagnol à 0,70 ou un segment de questions de remboursement qui échoue une fois sur cinq. Taguez votre golden dataset, rapportez chaque métrique par segment et appliquez vos gates au pire segment autant qu’à la moyenne.
4. Pas de boucle de retour depuis la production. Si les échecs réels ne reviennent jamais dans le golden dataset, celui-ci s’éloigne peu à peu de ce que demandent les utilisateurs. La suite de tests continue de passer pendant que les plaintes augmentent. Un tri hebdomadaire qui transforme les échecs de production en nouveaux cas de test est la correction la moins coûteuse de cette liste.
5. Ne tester que le chemin nominal. Un jeu de données construit à partir de questions propres et bien formulées passe à côté de ce qui casse réellement les fonctionnalités LLM : demandes ambiguës, questions hors périmètre, prompt injection, entrées très longues et utilisateurs qui changent de langue en cours de conversation. Visez au moins un cinquième de cas limites et adverses dans chaque jeu de données à risque élevé.
Comment QAwerk construit et opère l’évaluation des LLM
La plupart des équipes font appel à nous à l’un de deux moments : avant le lancement d’une première fonctionnalité LLM, ou après qu’un changement de modèle ou de prompt a déjà provoqué une régression visible. Nous démarrons là où en est le projet. Sur un produit existant, la première étape est généralement un audit de ce que l’équipe mesure déjà, suivi d’un golden dataset construit à partir du trafic réel et des cas d’usage à risque élevé.
À partir de là, nos ingénieurs QA mettent en place les six composants décrits plus haut :
- Des cas d’usage classés par niveau de risque et des objectifs d’évaluation écrits, validés avec votre product owner
- Un golden dataset versionné, avec des tags de segment et des cas adverses
- Des métriques et des évaluateurs adaptés à chaque objectif, avec des juges LLM calibrés par rapport à des étiquettes humaines
- Des exécutions d’évaluation intégrées à votre pipeline de CI, avec des gates de release stricts et souples
- Un échantillonnage de la production et un tri hebdomadaire des échecs qui maintient le jeu de données à jour
La mission fonctionne comme une extension de votre équipe : nous utilisons votre dépôt, votre CI et les outils que vous avez choisis, si bien que rien n’est à migrer quand nous nous retirons. Pour les produits fortement basés sur la récupération, le même dispositif s’étend à des tests RAG dédiés du retriever, du découpage et de l’ancrage.
Si vous voulez que nous construisions et fassions tourner un cadre d’évaluation pour vous, nos ingénieurs QA peuvent mettre en place votre golden dataset, vos métriques, vos juges calibrés et vos gates de CI, puis les maintenir à jour au fil des évolutions de votre produit. Parlez-nous de votre produit LLM et nous vous suggérerons par où commencer.
FAQ
Quels sont les 5 meilleurs outils d’évaluation des LLM ?
Pour la plupart des équipes, les cinq outils à présélectionner sont DeepEval, Ragas, Promptfoo, LangSmith et Langfuse. DeepEval convient aux équipes Python qui écrivent leurs evals comme des tests, Ragas est spécialisé dans les métriques RAG, Promptfoo excelle dans la comparaison de prompts et de modèles ainsi que dans le red teaming, LangSmith est adapté aux applications basées sur LangChain, et Langfuse est la principale option open source pour combiner traçage auto-hébergé et évaluation.
Comment se déroule l’évaluation d’un LLM ?
Vous faites passer un ensemble fixe d’entrées de test (un golden dataset) dans la fonctionnalité LLM, vous notez chaque sortie avec des métriques comme la faithfulness, la relevancy ou la task completion, et vous comparez les scores à des seuils convenus ou à la version actuellement en production. La notation combine des contrôles par code, des évaluateurs LLM-as-a-judge calibrés par rapport à des étiquettes humaines et une revue humaine d’un échantillon.
Quelles sont les 6 étapes d’un cadre d’évaluation des LLM ?
Les six étapes d’un cadre d’évaluation des LLM sont : définir les cas d’usage et les niveaux de risque, constituer un golden dataset, choisir les métriques, choisir les évaluateurs et calibrer les juges, intégrer les évaluations à la CI avec des gates de release, et surveiller la production en réinjectant les échecs dans le jeu de données.
Qu’est-ce qu’un framework LLM ?
« Framework LLM » désigne généralement une bibliothèque pour développer des applications LLM, comme LangChain ou LlamaIndex, qui gère les prompts, la récupération et les appels d’outils. Un cadre d’évaluation des LLM est autre chose : c’est le processus et l’outillage qui permettent de mesurer si ces applications produisent de bonnes sorties. La plupart des produits ont besoin des deux.
DeepEval est-il gratuit ?
Oui, la bibliothèque DeepEval est gratuite et open source sous licence Apache 2.0, et vous pouvez l’exécuter en local ou en CI sans autre coût que les appels API au modèle juge effectués par ses métriques. Confident AI, l’entreprise qui la développe, vend une plateforme hébergée pour l’historique des tests et la collaboration, avec une offre gratuite limitée et des offres payantes.
Cadre ou plateforme : de quoi ai-je besoin ?
Toute équipe a besoin d’un cadre, c’est-à-dire des objectifs, d’un jeu de données, de métriques et de seuils. Savoir s’il vous faut aussi une plateforme dépend de l’échelle : une seule fonctionnalité LLM avec un trafic modeste tourne très bien avec une bibliothèque open source en CI, tandis que le traçage de la production, les files de revue humaine et l’accès pour des profils non techniques sont les raisons habituelles d’ajouter une plateforme.
Découvrez comment nous avons construit et maintenu plus de 1 100 cas de test pour Granola, un bloc-notes IA, et automatisé 76 % de sa suite de régression