Quand des tests échouent parce que les données ont changé sous leurs pieds, ou qu’une livraison attend pendant des jours une base de données rafraîchie, l’équipe paie le prix d’une gestion des données de test insuffisante. Selon le rapport 2026 de Perforce Delphix sur la gestion des données de test, 99 % des entreprises attendent plus d’un jour ouvré pour obtenir une copie complète et à jour de la production pour leurs données de test, et 42 % attendent des semaines, voire des mois.
Les produits d’IA relèvent encore les enjeux, car un agent ou un LLM n’est testable qu’à la hauteur des données qu’on lui fournit. C’est pourquoi nos services de test d’agents IA incluent la génération de données synthétiques et la simulation de cas limites réels à chaque mise à jour d’un agent. Vous trouverez ci-dessous les approches qui rendent les données de test réalistes, sécurisées et reproductibles, les situations où chacune convient et celles où elle échoue, ainsi que la manière de choisir entre des outils et une aide extérieure.
Qu’est-ce que la gestion des données de test
La gestion des données de test consiste à créer, provisionner, protéger et maintenir les données sur lesquelles s’exécutent les tests. Bien menée, elle fournit à chaque test des données qui ressemblent à la production, ne contiennent aucune information personnelle exposée et restent identiques d’une exécution à l’autre, de sorte qu’un test en échec signale un vrai défaut.
Ces trois propriétés, réaliste, sécurisée et reproductible, constituent l’étalon que cet article applique à chaque approche. Elles correspondent à la capacité de gestion des données de test définie par DevOps Research and Assessment (DORA), le programme de recherche de Google Cloud consacré à la livraison logicielle. Selon ce programme, les équipes performantes disposent de suffisamment de données pour exécuter des suites automatisées complètes, peuvent obtenir ces données à la demande et ne laissent jamais les données limiter les tests qu’elles exécutent.
La plupart des organisations échouent sur les trois points, car personne n’est responsable du problème. L’enquête 2025 State of Test Data Management de K2view a révélé que la moitié des développeurs et des testeurs provisionnent et gèrent eux-mêmes les données de test.
Approches pour des données de test réalistes
Des données de test réalistes reproduisent les formes, les relations, les volumes et les cas limites de la production sans en être une copie. C’est important, car des données trop propres masquent les bugs que déclenchent les vrais utilisateurs : le client avec trois adresses de facturation, la commande passée pendant un changement de devise, le champ nul laissé par un ancien import.
Dans le même rapport de Perforce Delphix, 39 % des entreprises déclarent rencontrer des problèmes de qualité ou de validité dans leurs données de test. Le chemin le plus rapide vers le réalisme, copier intégralement la production, échoue d’emblée au critère de sécurité. Chaque approche ci-dessous part plutôt d’un jeu de données plus restreint ou généré.
Sous-ensembles de production
L’extraction de sous-ensembles prélève une petite tranche de la production dont l’intégrité référentielle est préservée : quelques milliers de clients avec toutes leurs commandes et factures, au lieu de la base entière. Elle se charge rapidement et conserve des combinaisons réelles que les générateurs ne produisent pas. Évitez-la lorsque la tranche contient encore des données personnelles brutes, car un sous-ensemble de 2 % d’une base de données de santé reste constitué d’informations de santé protégées.
Génération synthétique à base de règles
La génération à base de règles construit les données à partir du schéma et des règles métier, ce qui vous permet de créer les cas que la production contient rarement, comme un renouvellement un 29 février ou un nom de famille de 255 caractères. La même enquête de K2view a montré que le test des cas limites est le premier cas d’usage des données tabulaires synthétiques, cité par 53 % des organisations dans l’ensemble et par 70 % dans les services financiers. Le coût est l’effort, puisqu’il faut quelqu’un pour maintenir les règles en phase avec le produit.
Données synthétiques générées par l’IA
Les modèles génératifs produisent rapidement des enregistrements plausibles, y compris du texte libre comme des tickets de support, que les règles gèrent mal. De nombreuses équipes les utilisent déjà, mais peu en ont fait une composante habituelle de leurs tests : le World Quality Report 2025-26 a constaté que 95 % des organisations utilisent l’IA générative pour produire des données de test. Seules 10 % l’ont pleinement intégrée à leur cycle de développement. Les enregistrements générés par l’IA peuvent sembler convaincants un par un tout en étant faussés dans leur ensemble, par exemple avec trop peu de champs vides ou trop de clients d’un même pays. Avant de vous y fier, comparez-les à la production sur quelques mesures de base : les plages de valeurs habituelles, la fréquence des champs laissés vides et la fréquence d’apparition de chaque catégorie.
Approches pour des données de test sécurisées
Des données de test sécurisées ne contiennent aucune donnée personnelle ou réglementée réelle, ou les protègent si complètement qu’aucun enregistrement ne peut être rattaché à une personne. C’est la propriété que la plupart des équipes croient acquise et que le moins d’entre elles atteignent réellement, car les environnements hors production font l’objet d’une surveillance moindre que la production tout en contenant une grande partie des mêmes données.
L’enquête 2026 State of Enterprise Data Compliance de K2view a révélé que 88 % des organisations déclarent une conformité totale en production, mais seules 4 % affirment que leurs environnements de développement et de test sont entièrement conformes. Le rapport IBM Cost of a Data Breach Report 2026 chiffre le coût moyen mondial d’une violation de données à 4,99 millions de dollars, un record.
Masquage statique et tokenisation
Le masquage statique remplace les valeurs sensibles par des valeurs fictives avant que les données n’atteignent un environnement de test, tandis que la tokenisation les remplace par des jetons que seul un coffre sécurisé peut faire correspondre aux valeurs d’origine. Les deux doivent rester cohérents d’un système à l’autre. Si le client 4471 devient « Jane Doe » dans le CRM et « Mark Lee » dans la facturation, toutes les jointures cassent. Le masquage a aussi ses limites, car une date de naissance réelle, un code postal et un diagnostic rare peuvent encore identifier une personne une fois le nom supprimé.
Données synthétiques d’abord pour les domaines réglementés
Pour la santé, la fintech et tout produit soumis au Règlement général sur la protection des données (RGPD) ou au Health Insurance Portability and Accountability Act (HIPAA), l’option par défaut la plus sûre consiste à privilégier les données synthétiques, en ne recourant aux données masquées que lorsque les données synthétiques ne peuvent pas reproduire un comportement. Des données qui n’ont jamais été réelles ne peuvent pas exposer un vrai patient ou un vrai titulaire de compte. Les régulateurs examinent aussi les environnements de test, l’approche doit donc résister à vos tests de conformité avant qu’un auditeur ne la vérifie.
Moins de copies, à durée de vie plus courte
Chaque copie d’un jeu de données élargit l’exposition, et les copies ont tendance à survivre aux projets qui les ont créées. Les environnements éphémères, détruits après chaque exécution de tests, éliminent l’essentiel de ce risque lorsqu’ils sont associés à un contrôle d’accès basé sur les rôles et à une étape de nettoyage. Les missions de test d’intrusion de QAwerk incluent une étape de nettoyage, et les environnements de test exigent la même habitude.
Approches pour des données de test reproductibles
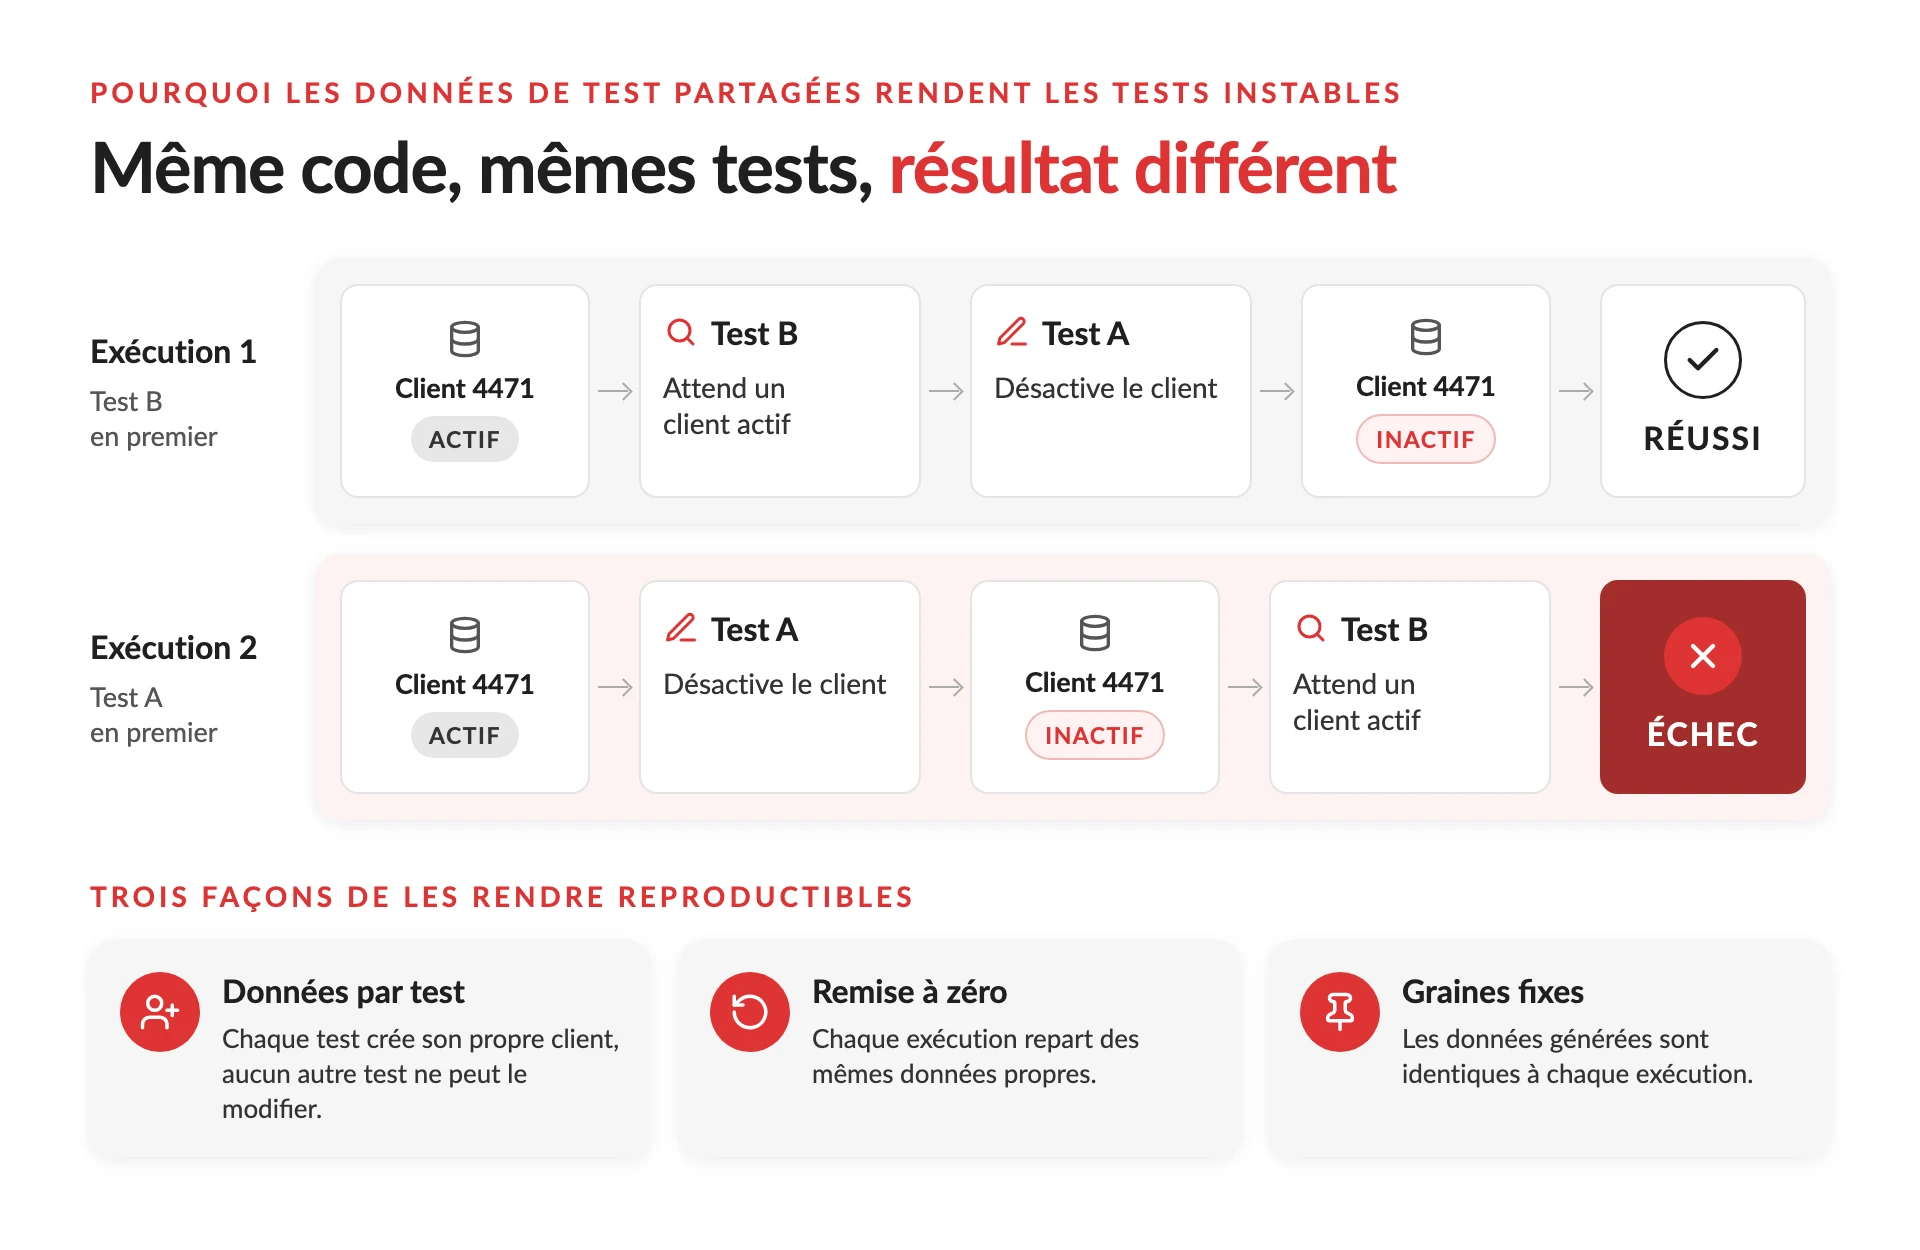
Des données de test reproductibles placent chaque test dans le même état connu à chaque exécution, quels que soient les tests exécutés avant lui ou les modifications apportées par une autre équipe dans un environnement partagé. Sans elles, les échecs ne veulent plus rien dire : le même commit passe le mardi et échoue le mercredi, et les ingénieurs prennent l’habitude de relancer les builds au lieu d’en chercher la cause.
Les données partagées et modifiables sont l’une des principales sources de tests instables. Le mécanisme est la dépendance à l’ordre : un test réussit ou échoue selon ce qu’un test précédent a laissé dans la base de données, un cache ou un fichier. Dans une étude portant sur 7 571 tests instables issus de 22 352 projets Python, la dépendance à l’ordre était à l’origine de 59 % d’entre eux.
Les problèmes de timing provoquent aussi des tests instables. Une analyse antérieure de 201 corrections de tests instables classait la dépendance à l’ordre en troisième position, derrière les attentes asynchrones et la concurrence. Quand un build rouge peut n’être que du bruit, les équipes livrent malgré de vrais échecs ou se bloquent sur de faux. Des données stables sont ce qui permet aux tests de régression de donner une réponse fiable à chaque build.
Données propres à chaque test
Chaque test crée les enregistrements dont il a besoin lors de sa mise en place, via les propres API de l’application, et ne fait ses assertions que sur ces enregistrements. Les recommandations de DORA préconisent cette approche, car elle supprime la dépendance à un jeu de données partagé et permet d’exécuter les tests en parallèle. Le coût est une mise en place plus lente et davantage de code de test, que les factories et les builders de données permettent de garder maîtrisables.
Réinitialisation et isolation
Quand les tests ont besoin d’une base de référence plus volumineuse, isolez-la et réinitialisez-la entre les exécutions : annulez une transaction de base de données (rollback) après chaque test, restaurez un snapshot entre les suites ou démarrez une base de données conteneurisée neuve à chaque exécution CI. Le rollback est le plus rapide, mais il échoue pour le code qui valide ses propres transactions, tandis que les conteneurs coûtent du temps de démarrage et offrent l’isolation la plus forte pour les pipelines parallèles. Notre checklist de tests back-end couvre les vérifications de base de données à effectuer pour chaque configuration.
Jeux de données versionnés et graines fixes
Stockez les scripts de seed et les configurations des générateurs dans le même dépôt que le code, et fixez la graine aléatoire de toute donnée générée. Un échec signalé en mars pourra alors être reproduit en juin avec le jeu de données exact qui l’a déclenché.
Comparatif des approches de gestion des données de test
Aucune approche de gestion des données de test n’est à la fois réaliste, sécurisée et reproductible. Les copies de production sont réalistes mais non sécurisées, les données synthétiques sont sécurisées mais demandent du travail pour rester réalistes, et les données propres à chaque test sont reproductibles mais limitées. Le tableau note chaque approche pour vous permettre de choisir la combinaison qui comble vos lacunes.
Copie complète de la production
Élevé
Faible
Faible
Faible au départ, élevé en maintenance
Rarement justifiée
Sous-ensembles de production
Élevé
Faible sans masquage
Moyen
Moyen
Tests d’intégration et de bout en bout
Masquage statique
Élevé
Moyen
Moyen
Moyen à élevé
Environnements de QA et de préproduction partagés
Tokenisation
Élevé
Moyen à élevé
Moyen
Élevé
Champs de paiement et identifiants
Synthétique à base de règles
Moyen
Élevé
Élevé
Moyen à élevé
Cas limites, domaines réglementés, tests de charge
Synthétique généré par l’IA
Moyen, après validation
Élevé
Moyen
Faible à moyen
Champs de texte libre, gros volumes
Données propres à chaque test
Faible à moyen
Élevé
Élevé
Moyen
Tests unitaires, d’API et fonctionnels
Snapshot et réinitialisation
Identique à la base de référence
Identique à la base de référence
Élevé
Moyen
Suites de régression et de bout en bout
La plupart des équipes en combinent deux ou trois, généralement des données propres à chaque test pour les tests d’API, un sous-ensemble masqué avec réinitialisation par snapshot pour les exécutions de bout en bout, et des données synthétiques à base de règles pour les cas limites, car aucune approche n’obtient une note élevée sur les trois critères.
Données de test pour les tests d’IA et de LLM
Les systèmes d’IA ont besoin de données de test d’un autre type : des jeux de données d’évaluation organisés, des entrées adverses et des cas limites, ainsi que des réponses de référence versionnées, afin de pouvoir comparer les résultats d’une mise à jour du modèle, du prompt ou du mécanisme de récupération à l’autre. Sans jeu d’évaluation fixe, impossible de savoir si une nouvelle version du modèle a amélioré les réponses ou les a seulement rendues différentes.
Les sorties des grands modèles de langage (LLM) varient d’une exécution à l’autre, c’est pourquoi les jeux d’évaluation sont notés selon des critères comme l’exactitude par rapport à une réponse de référence, le refus des demandes hors périmètre ou le bon appel d’outil pour un agent. Les cas limites demandent ici aussi une conception délibérée : injections de prompt, questions ambiguës, entrées multilingues et questions auxquelles la base de connaissances ne peut pas répondre.
Pour le bloc-notes IA de Granola, QAwerk a construit un jeu d’évaluation sur mesure couvrant des scénarios de réunion réels, un audio ambigu et de longues conversations à plusieurs tours. Versionnez un tel jeu de données avec les prompts et la configuration du modèle, afin qu’une régression puisse être rattachée à la modification qui l’a provoquée. Lorsque vous comparez des services de test de LLM, demandez comment le prestataire construit et maintient ces jeux de données, car c’est le jeu de données qui définit ce que les tests peuvent détecter.
Comment choisir des outils de gestion des données de test
Choisissez un logiciel de gestion des données de test selon les sources de données qu’il prend en charge, la capacité de son masquage à préserver l’intégrité référentielle entre ces sources, son intégration à votre pipeline CI/CD et la possibilité pour les testeurs de provisionner eux-mêmes les données au lieu d’ouvrir un ticket et d’attendre des jours.
La même enquête de K2view a révélé que 90 % des utilisateurs de solutions de gestion des données de test (TDM) s’appuient sur des outils de plus de 15 ans. Elle a aussi montré que 49 % des dirigeants de niveau C sont satisfaits de leur TDM, contre 5 % des managers. Avant d’acheter, demandez aux personnes qui provisionnent les données au quotidien ce qui les ralentit.
Les critères sur lesquels évaluer chaque candidat :
- Couverture des sources : chaque base de données, stockage de fichiers et système SaaS que vos tests sollicitent.
- Intégrité référentielle sous masquage : un même client est masqué avec les mêmes valeurs partout.
- Génération synthétique : à base de règles au minimum, assistée par l’IA en option pour les champs de texte libre.
- Libre-service et intégration CI/CD : une API ou une CLI que le pipeline peut appeler pour provisionner et supprimer les données.
- Rapports de conformité : la preuve de ce qui a été masqué, où et quand.
- Modèle de licence : les tarifs par base de données, par utilisateur et par volume divergent fortement à mesure que les environnements se multiplient.
Les outils de gestion des données de test se répartissent en trois catégories, et les acheteurs comparent les solutions commerciales sur Gartner Peer Insights :
- Les plateformes d’entreprise comme Perforce Delphix, K2view et IBM InfoSphere Optim gèrent le masquage et le provisionnement sur de nombreuses sources à grande échelle.
- Les outils centrés sur les bases de données comme Redgate Test Data Manager et DATPROF couvrent l’extraction de sous-ensembles et le masquage pour un nombre plus restreint de bases, avec moins de configuration.
- Les bibliothèques open source comme Faker génèrent des valeurs synthétiques dans le code de test sans coût de licence, en vous laissant la charge de l’intégrité référentielle.
Quel que soit votre choix, un outil ne règle pas la question de la responsabilité. Les solutions de gestion des données de test automatisent le provisionnement et le masquage, mais quelqu’un doit encore décider quelles approches s’appliquent à quelles suites et retirer les copies obsolètes. Sans cette personne, acheter un logiciel déplace le problème sans le résoudre.
Quand faire appel à des services de gestion des données de test
Faites appel à des services de gestion des données de test lorsque personne n’est responsable des données de test, lorsque des tests instables bloquent régulièrement les livraisons, ou lorsqu’un audit ou une nouvelle réglementation impose un nettoyage des environnements hors production. Dans chaque cas, ce qui manque relève des personnes et des processus, ce qu’un outil ne peut pas combler à lui seul.
Le premier déclencheur est organisationnel. Les développeurs alimentent eux-mêmes leurs données, la QA tient un tableur des comptes de test qui fonctionnent encore, et la préproduction est rafraîchie quand quelqu’un y pense. Une équipe QA dédiée peut cartographier les besoins de chaque suite, choisir des approches à partir du tableau comparatif et documenter la configuration.
Le deuxième déclencheur est un pipeline auquel personne ne fait confiance. Si les ingénieurs relancent les builds en échec par habitude, les données de test en sont une cause probable, et la correction passe par la reconstruction des fixtures, de la logique de réinitialisation et de l’alimentation des données au sein même du framework de tests automatisés.
Le troisième déclencheur est la pression extérieure. Une demande d’exercice de droits d’une personne concernée au titre du RGPD, un contrôle au titre du règlement sur la résilience opérationnelle numérique dans une entité financière de l’UE ou un audit raté peuvent révéler de vraies données clients présentes en préproduction. Dans le 2026 State of Data Compliance and Security Report de Perforce, 43 % des organisations ont signalé des problèmes ou des échecs d’audit dans des environnements hors production.
Pourquoi travailler avec QAwerk
Les problèmes de données de test se manifestent par des échecs de régression aléatoires, des données personnelles en préproduction et des comptes de test qui ne ressemblent pas aux vrais utilisateurs. QAwerk teste des logiciels depuis 2015, sur plus de 300 projets en Amérique du Nord, en Australie, en Europe, en Corée du Sud et en Afrique, et figure dans le classement Global Outsourcing 100 de l’International Association of Outsourcing Professionals (IAOP).
Dans la pratique, des données de test stables sont ce qui garantit un calendrier de livraison prévisible. QAwerk aide ClickHouse à maintenir des livraisons hebdomadaires et à fournir de manière fiable des mises à jour à Microsoft, IBM et d’autres clients de premier plan. L’équipe a également automatisé 70 % des scénarios de test d’une application de paiement basée sur des microservices.
La gestion des données de test est un travail continu, et nos ingénieurs QA peuvent intervenir à n’importe quel stade de votre suite de tests. Si les données de test freinent vos livraisons, contactez-nous pour discuter de votre configuration.
FAQ
Qu’est-ce que la gestion des données de test ?
La gestion des données de test consiste à créer, provisionner, protéger et maintenir les données sur lesquelles s’exécutent les tests logiciels. Son objectif est d’obtenir des données de test qui ressemblent à la production, n’exposent aucune information personnelle réelle et restent identiques d’une exécution à l’autre, afin que chaque échec de test signale un vrai défaut et non un problème de données.
Quelle est la différence entre le masquage des données et les données de test synthétiques ?
Le masquage des données part d’enregistrements de production réels et remplace les valeurs sensibles par des valeurs fictives, en conservant la structure et les relations du monde réel. Les données de test synthétiques sont générées à partir de règles ou de modèles et n’ont jamais été réelles. Le masquage préserve le réalisme mais comporte un risque de réidentification, tandis que les données synthétiques sont plus sûres par conception mais doivent être validées pour reproduire le comportement de la production.
Comment les données de test provoquent-elles des tests instables ?
Les données de test provoquent des tests instables lorsque les tests partagent des données modifiables. Un test modifie ou supprime un enregistrement dont dépend un autre test, si bien que les résultats dépendent de l’ordre d’exécution ou du timing. Dans une étude portant sur 7 571 tests Python instables, la dépendance à l’ordre était à l’origine de 59 % d’entre eux. Des données propres à chaque test, des réinitialisations entre les exécutions et des graines fixes éliminent l’essentiel de ce risque.
Que rechercher dans une solution de gestion des données de test ?
Recherchez la couverture de toutes les sources de données utilisées par vos tests, un masquage qui préserve l’intégrité référentielle entre les systèmes, la génération de données synthétiques, une API ou une CLI pour le provisionnement en libre-service dans la CI/CD, et des rapports de conformité prêts pour l’audit. Vérifiez que les licences restent abordables à mesure que les environnements se multiplient, et décidez qui, dans votre équipe, sera responsable des approches que l’outil exécute.
Découvrez comment nous avons construit et maintenu plus de 1 100 cas de test pour Granola, un bloc-notes IA, et automatisé 76 % de sa suite de régression