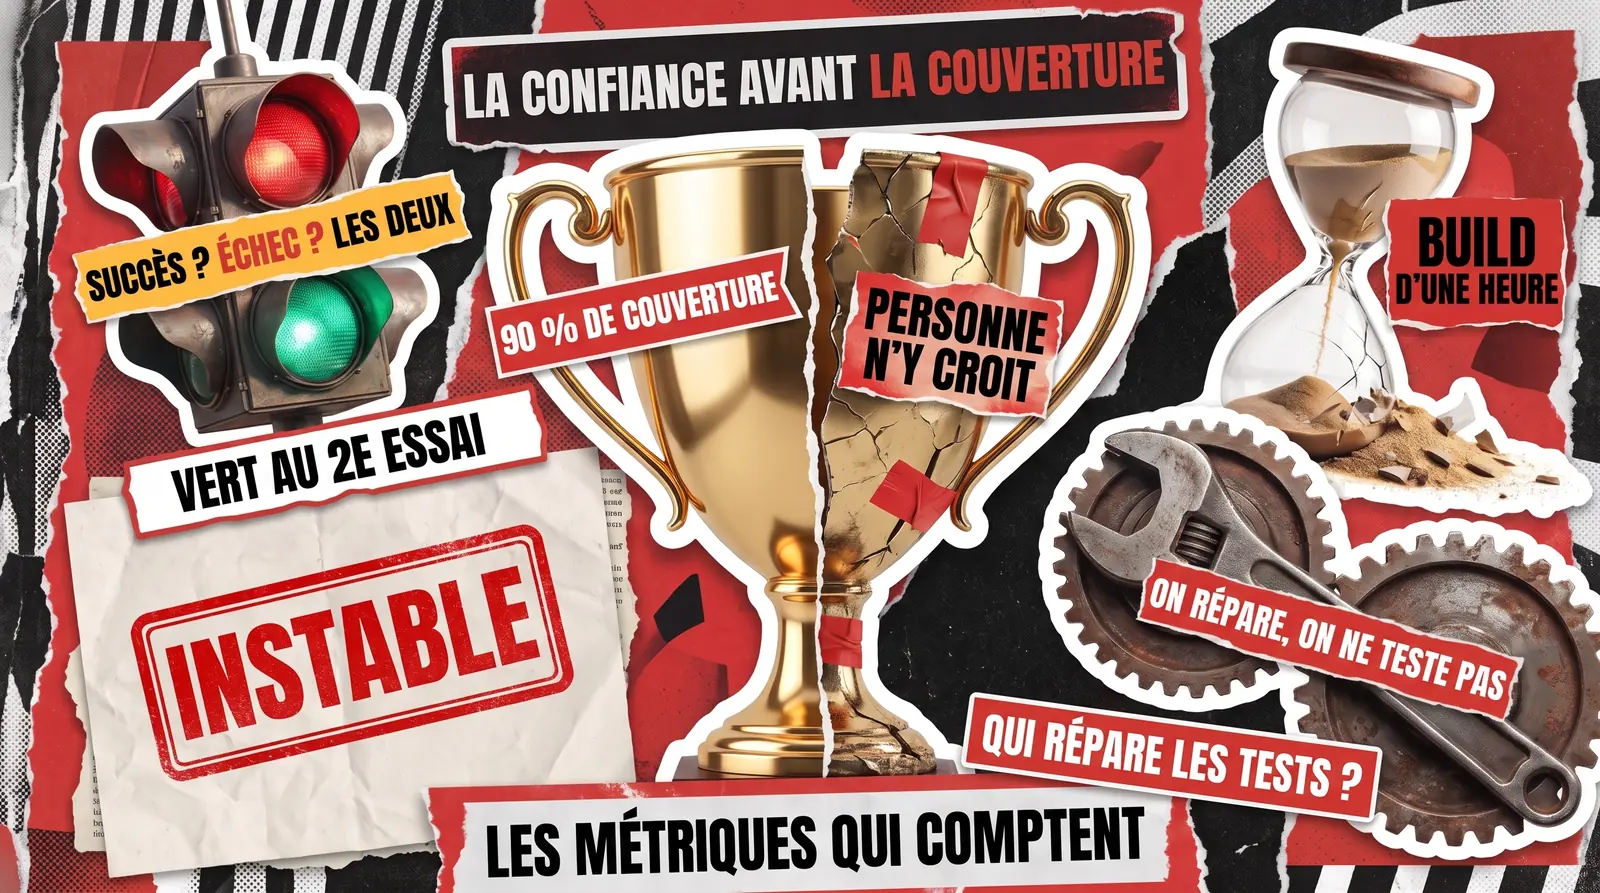
Le pourcentage de couverture des tests est le chiffre d’automatisation le plus facile à mettre sur une diapositive, et l’un des moins utiles à lui seul. Une suite couvrant 90 % du code qui tourne pendant une heure et échoue au hasard vous en dit moins qu’une suite plus petite à laquelle votre équipe se fie à chaque merge. Une mauvaise lecture se paie en heures d’ingénierie : chaque build rouge inexpliqué oblige quelqu’un à relancer le pipeline, à lire les logs et à décider s’il peut se fier au résultat.
Les métriques d’automatisation des tests qui comptent vraiment sont le taux de tests instables, le temps d’exécution de la suite, le coût de maintenance et l’évolution du taux de réussite d’une version à l’autre. Ensemble, elles montrent si les développeurs font confiance aux résultats, si le feedback arrive assez vite pour agir et si la suite devient moins chère ou plus chère à entretenir. La couverture reste un contexte utile pour les interpréter.
Si vos tests automatisés tournent sans équipe dédiée pour s’en occuper, les métriques ci-dessous sont aussi le moyen le plus rapide de voir où la suite vous fait perdre du temps.
Pourquoi le taux de couverture seul est trompeur
La couverture mesure l’étendue. Elle vous dit quelle part du code, ou combien de cas de test, la suite touche, et rien sur la capacité de ces tests à détecter une vraie régression. Une suite peut atteindre 100 % de couverture de lignes sur des getters et du code de configuration alors que le parcours de paiement, le modèle de permissions et la migration de données restent non testés.
Le chiffre est aussi facile à gonfler. Les tests sans assertions significatives, ceux qui confirment seulement qu’une page se charge et les vérifications dupliquées entre couches augmentent la couverture sans augmenter la confiance. Dès que la couverture devient un objectif, les équipes écrivent les tests qui la font progresser le plus vite, et ce sont rarement ceux qui protègent le chiffre d’affaires.
Selon le World Quality Report 2025-26 de Capgemini, seul un tiers des cas de test est automatisé en moyenne, et seuls 4 % des répondants automatisent 76 % à 100 % de leurs cas de test. Le même rapport recommande de remplacer le « % de tests automatisés » par des indicateurs liés à l’impact client, à la vélocité des livraisons et au confinement des défauts.
Une version plus utile de la couverture est la couverture des parcours critiques : la part des parcours qui vous coûteraient des utilisateurs ou du chiffre d’affaires s’ils tombaient en panne, chacun protégé par au moins une vérification fiable dans vos tests fonctionnels automatisés. S’accorder sur cette liste est la première étape de l’évaluation QA stratégique qui ouvre chaque mission de tests automatisés chez QAwerk.
Les métriques d'automatisation des tests en un coup d'œil
Chaque métrique du tableau répond à une question différente sur votre suite : peut-on lui faire confiance, est-elle assez rapide, et vaut-elle ce qu’elle coûte à entretenir. Aucune ne fonctionne bien seule. Un faible taux de tests instables signifie peu de chose si la suite ignore vos parcours les plus risqués, c’est pourquoi la couverture des parcours critiques figure dans le même tableau.
Taux de tests instables
Si l’on peut se fier à un échec
Tests ayant à la fois réussi et échoué sur le même commit, divisés par les tests exécutés, sur les 50 à 100 dernières exécutions
Le taux augmente, ou les relances deviennent la routine
Temps d’exécution de la suite
La vitesse à laquelle les développeurs reçoivent un feedback
Exécution médiane et la plus lente du pipeline par version, plus le délai entre le push et le premier résultat
Les exécutions ralentissent sans protéger davantage de parcours critiques
Ratio de maintenance
Ce que coûte l’entretien de la suite
Heures passées à réparer les tests existants divisées par les heures passées à en écrire de nouveaux, par sprint
Les réparations dépassent les nouveaux tests plusieurs sprints d’affilée
Évolution du taux de réussite
Si la qualité s’améliore ou se dégrade
Taux de réussite à la première exécution par version, chaque échec étant classé en défaut produit, défaut de test ou environnement
La tendance baisse, ou « défaut de test » devient le verdict le plus fréquent
Couverture des parcours critiques
Si les parcours à risque sont protégés
Parcours critiques dotés d’une vérification automatisée fiable, divisés par l’ensemble des parcours critiques
Des lacunes dans les parcours de paiement, de permissions ou d’intégrité des données
Couverture brute en %
Ce que la suite touche
Lignes, branches ou cas de test couverts
C’est le seul chiffre que quiconque rapporte
Comment mesurer le taux de tests instables
Un test instable réussit et échoue sur le même code sans que rien n’ait changé entre-temps. Le taux de tests instables est la part des tests qui ont fait les deux sur une période donnée, généralement les 50 à 100 dernières exécutions du pipeline ou les deux dernières semaines. Suivez-le test par test ainsi que pour l’ensemble de la suite, car quelques tests produisent généralement l’essentiel du bruit.
Il occupe la place centrale parmi les métriques d’automatisation des tests parce qu’il détermine si quelqu’un lit encore les résultats. Dès que les développeurs comprennent qu’un build rouge ne signifie souvent rien, ils relancent jusqu’à obtenir du vert et commencent à merger malgré les échecs, et les vraies régressions se cachent parmi les fausses alertes. Dans une enquête Gartner Peer Community de 2023 menée auprès de 248 responsables IT et ingénierie logicielle, 31 % citaient les imprécisions des tests automatisés parmi leurs principaux défis, et 21 % un manque de confiance dans les outils ou les fournisseurs d’automatisation.
Trois chiffres méritent d’être suivis ensemble :
- Taux de tests instables : tests aux résultats contradictoires sur le même commit, divisés par les tests exécutés.
- Taux de relance : exécutions du pipeline qui ont nécessité une nouvelle tentative avant de réussir.
- Durée de quarantaine : depuis combien de temps les tests instables restent hors de la suite principale sans correctif.
Comptez la première tentative. Les relances automatiques masquent l’instabilité dans le taux de réussite, si bien qu’une suite qui ne passe au vert qu’au deuxième essai peut afficher zéro échec tout en coûtant une relance à l’équipe à chaque merge. Notre guide sur les tests instables détaille les causes et les solutions ; la métrique vous dit si le problème s’aggrave ou se résorbe.
Temps d'exécution et coût de maintenance, des métriques de ROI de l'automatisation des tests
L’automatisation est rentable quand elle fournit un feedback plus rapide que les vérifications manuelles pour un effort continu moindre. Le temps d’exécution et le coût de maintenance mesurent directement ces deux moitiés, ce qui en fait des métriques de ROI de l’automatisation des tests plus honnêtes qu’un chiffre projeté d’« heures économisées ». Dans la même enquête Gartner Peer Community, 23 % des responsables citaient un ROI difficile à définir comme un défi majeur, et 16 % des coûts de maintenance élevés.
Temps d'exécution
Suivez l’exécution médiane et la plus lente par version, ainsi que le délai entre un push et le premier résultat. Le signal d’alerte est une suite qui ralentit sans rien protéger de nouveau, généralement à cause de tests de bout en bout qui dupliquent des vérifications mieux placées une couche plus bas. Les tests automatisés d’API sont souvent l’endroit où ce temps se récupère : une règle métier vérifiée via l’interface attend les connexions, les chargements de page et le rendu, alors que la même règle vérifiée directement sur l’endpoint s’en passe entièrement.
Coût de maintenance
Consignez les heures passées à réparer les tests existants séparément de celles passées à en écrire de nouveaux. Quand les réparations prennent systématiquement plus de temps que la nouvelle couverture, la suite consomme la capacité qu’elle devait libérer. Les causes courantes sont des sélecteurs fragiles, des tests qui partagent des données et des textes d’interface codés en dur dans les assertions. Ce dernier point est un problème bien connu des tests d’automatisation de la localisation, où chaque nouvelle langue peut casser des dizaines d’assertions d’un coup si les chaînes de chaque langue ne sont pas stockées dans des fichiers de ressources.
La conception du framework détermine une grande partie de ce coût dès le départ. Des patterns comme le Page Object Model limitent une modification d’interface à un seul fichier au lieu de chaque test qui touche cet écran. Le périmètre fait le reste : notre guide sur le test de régression automatisé explique quoi automatiser et quoi laisser aux humains. Les parcours stables et très fréquentés méritent d’être automatisés, tandis que les scénarios qui dépendent du matériel, d’interfaces tierces ou de mises en page qui changent souvent coûtent généralement plus cher à maintenir qu’ils ne font gagner.
Pourquoi l'évolution du taux de réussite compte plus qu'un instantané
Un taux de réussite isolé de 95 % en dit peu sur la santé de la suite. Ce qui compte, c’est l’évolution du chiffre d’une version à l’autre. Si le taux de réussite passe de 99 % à 95 % en trois versions, quelque chose se dégrade. S’il reste à 95 % mais que des tests différents échouent à chaque fois, c’est probablement la suite elle-même qui est instable.
Suivez le taux de réussite à la première exécution par version et classez chaque échec dans l’un de trois groupes : un vrai défaut produit, un défaut de test ou un problème d’environnement. Une part croissante de défauts produit signifie que la suite détecte des régressions et que le code demande de l’attention. Une part croissante de défauts de test et d’échecs d’environnement signifie que la suite elle-même se dégrade.
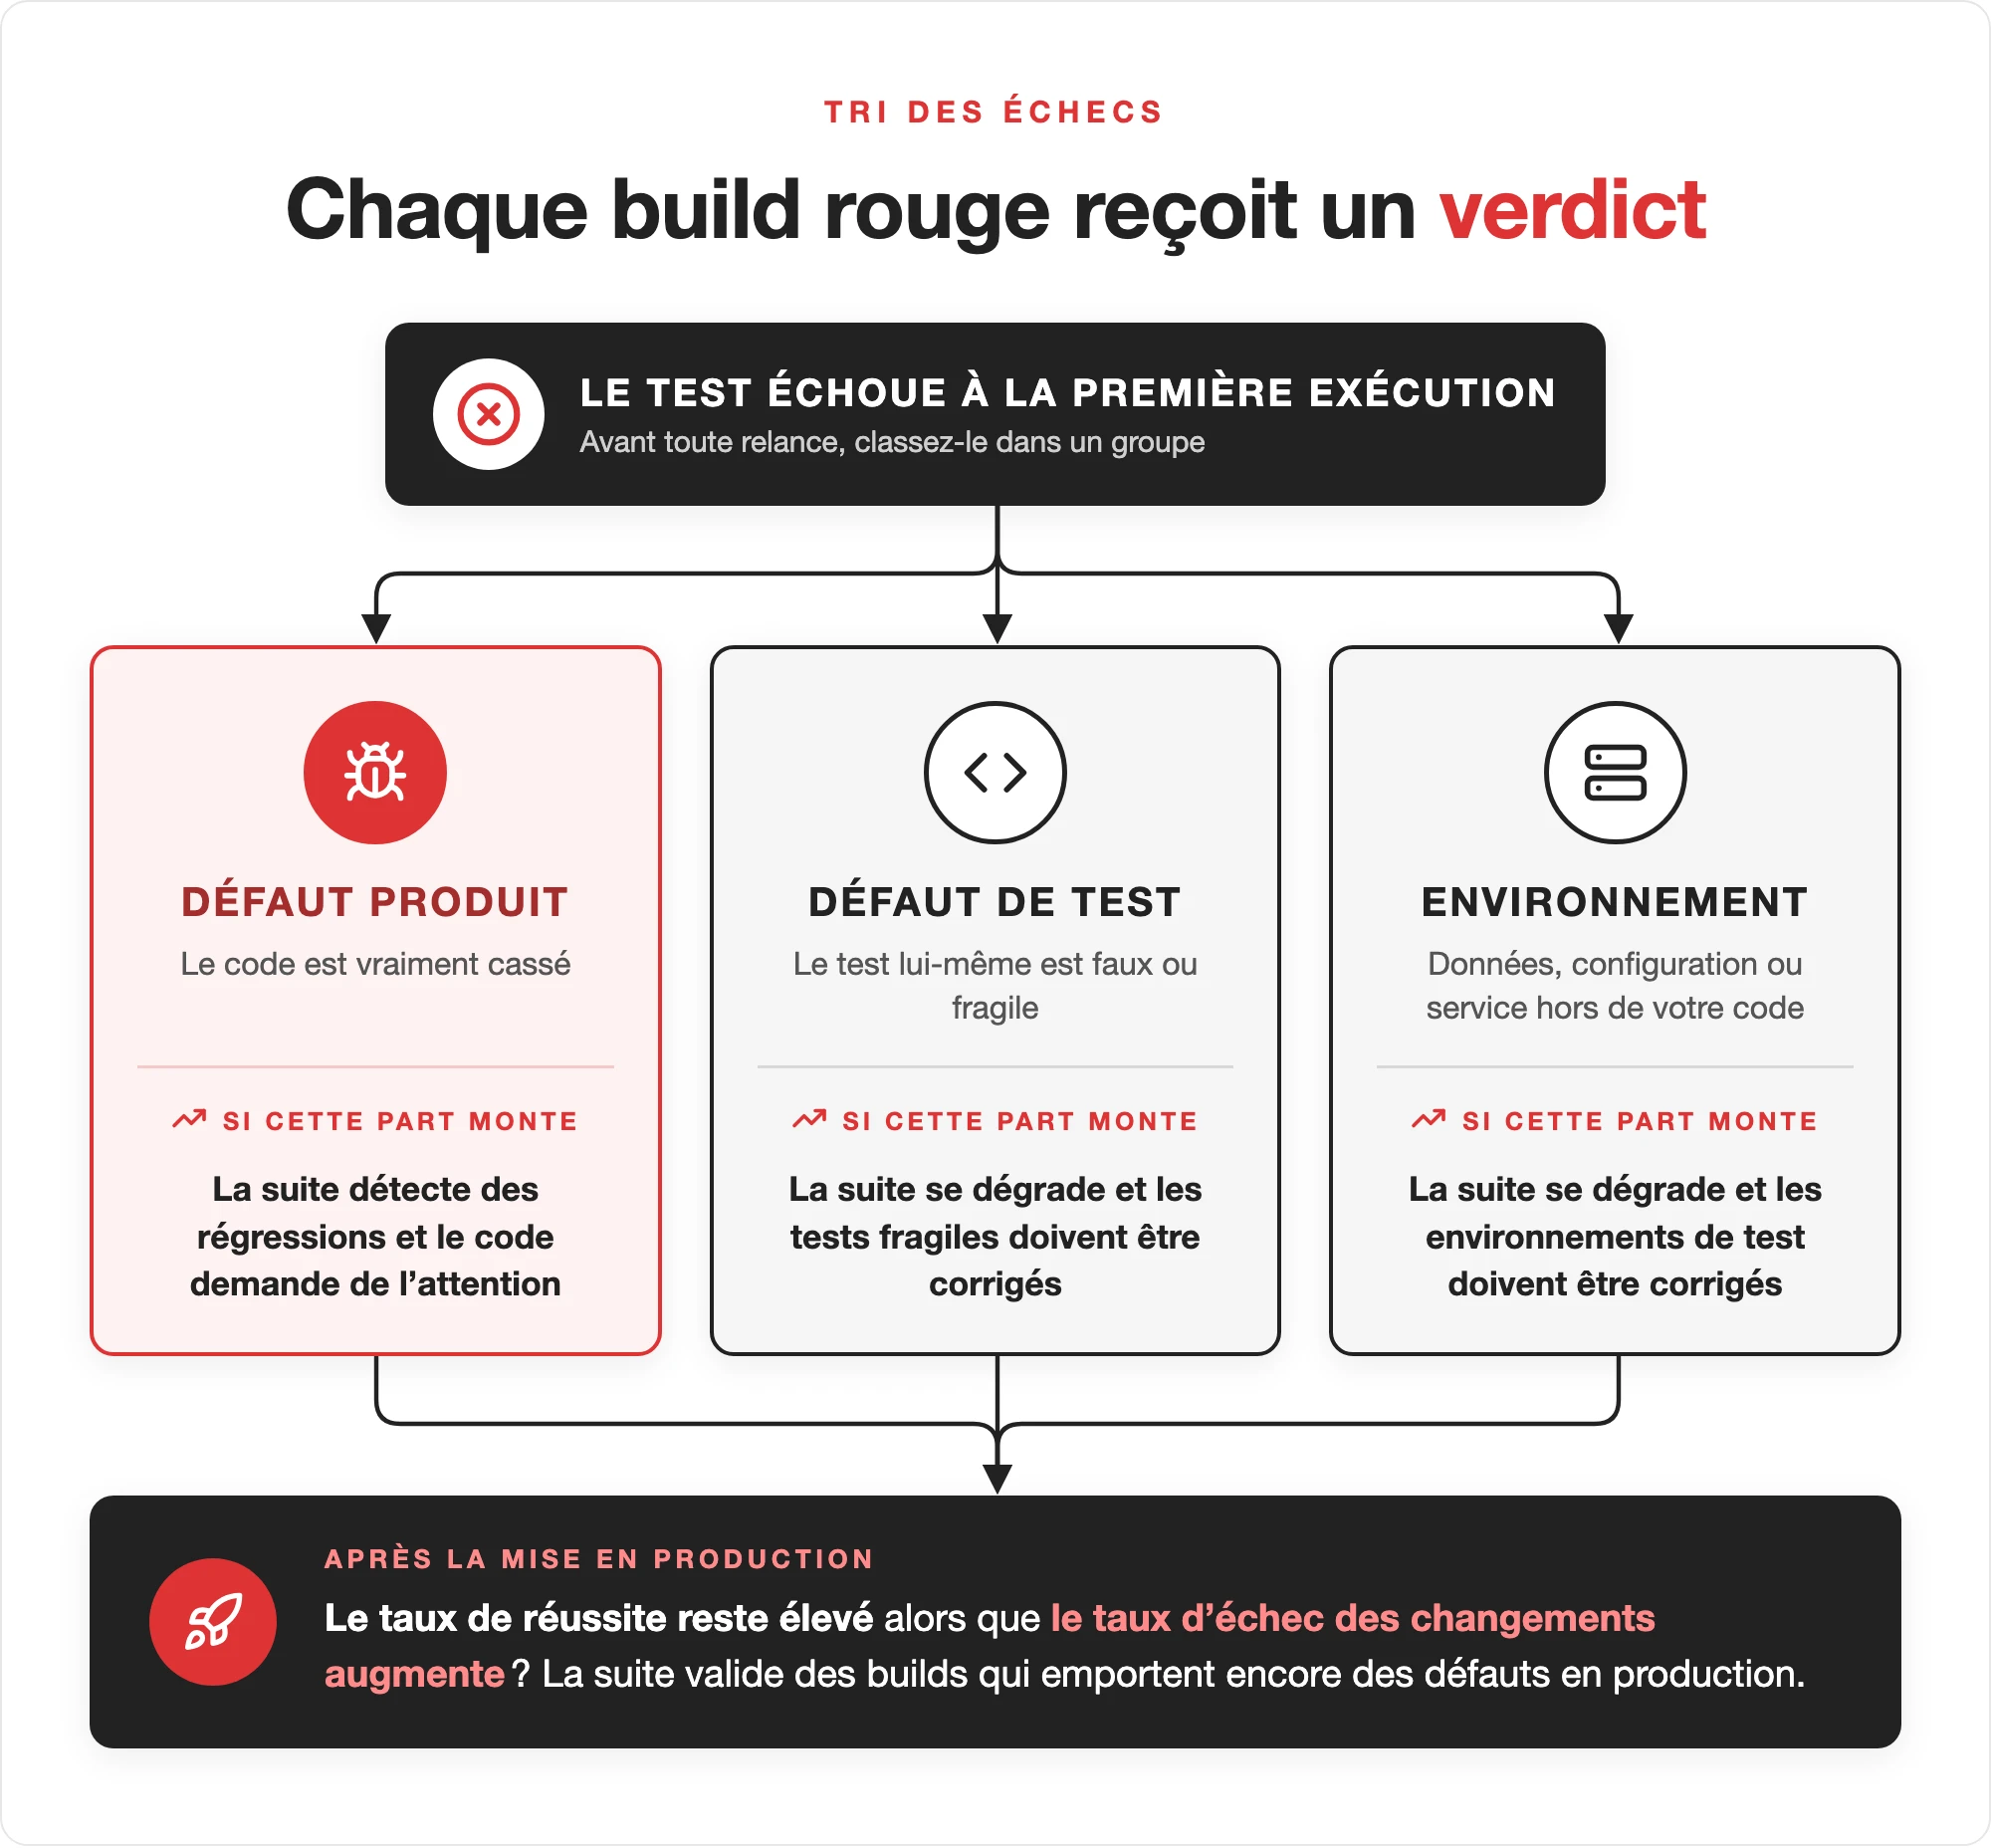
Reliez ensuite cette évolution à ce qui se passe après la mise en production. DORA, le programme DevOps Research and Assessment de Google, définit le taux d’échec des changements (change fail rate) comme la part des déploiements qui nécessitent une intervention immédiate, par exemple un rollback ou un hotfix. Si votre taux de réussite reste élevé alors que le taux d’échec des changements grimpe, la suite valide des builds qui embarquent encore des défauts en production. C’est d’autant plus important que l’IA accélère le développement : le rapport 2025 DORA State of AI-Assisted Software Development a constaté que l’adoption de l’IA améliore désormais le débit de livraison logicielle, mais augmente toujours l’instabilité des livraisons.
Quand ces métriques peuvent induire en erreur
Chacune de ces métriques peut être manipulée ou mal interprétée. Supprimer des tests instables fait baisser le taux d’instabilité, mais retire aussi de la protection, alors lisez ce taux avec la couverture des parcours critiques. Un temps d’exécution court peut signaler une suite efficace ou une suite qui saute les vérifications lentes et importantes. Les ratios de maintenance sont au plus mal pendant une refonte majeure, ce qui justifie un pic temporaire. Les métriques de suite disent aussi peu de chose de la qualité du produit à elles seules, alors lisez-les à côté d’indicateurs QA plus larges comme la densité de défauts, le confinement des défauts et le respect des délais, présentés dans notre panorama des métriques de test logiciel les plus importantes.
Les produits en phase de démarrage sont l’autre exception. Si l’interface change chaque semaine et que seuls quelques parcours sont stables, une automatisation UI poussée mesure surtout le changement. Un petit ensemble de vérifications d’API associé à une régression manuelle structurée est généralement un meilleur investissement jusqu’à ce que le produit se stabilise.
Comment QAwerk garde des suites automatisées dignes de confiance
Pour Granola, un bloc-notes IA qui publie des mises à jour chaque semaine, QAwerk a construit un framework d’automatisation des tests de zéro et automatisé 76 % de la suite de régression principale, soit plus de 150 vérifications exécutées avant chaque version. Une grande partie de ce résultat tient au choix de ce qu’il fallait laisser hors de la suite :
- Les scénarios audio dépendants du matériel et les parcours de paiement externes ont été confiés aux testeurs manuels, pour que la suite automatisée reste rapide et fiable.
- Les connexions tierces instables comme Google SSO ont été remplacées dans les tests par un helper d’authentification interne, pour éviter les faux échecs.
- Les résumés générés par l’IA, qui diffèrent à chaque exécution, sont vérifiés par un LLM quant au contexte et à l’exactitude, car des assertions de correspondance exacte échoueraient en permanence.
- L’exécution se fait en parallèle sur macOS et Windows via GitHub Actions, chaque nuit ou avant un merge, avec des résultats publiés dans Slack.
Chacun de ces choix cible le taux d’instabilité, le temps d’exécution ou le coût de maintenance, et ensemble ils permettent à Granola de tenir un rythme de livraison hebdomadaire. Nous pouvons intervenir à n’importe quelle étape : construire une suite de zéro, comme pour Granola, ou reprendre une suite existante et maîtriser son taux d’instabilité et son ratio de maintenance avant d’ajouter d’autres tests. Pour les entreprises sans QA interne, une équipe de test dédiée peut prendre en charge la suite sur le long terme, afin que quelqu’un suive ces métriques à chaque version.
Juger l'automatisation sur la confiance et le coût de maintenance
Une suite automatisée saine, c’est une suite que vos développeurs croient quand elle échoue et que votre budget peut se permettre d’entretenir. Des tests instables, lents et coûteux peuvent afficher d’excellents chiffres de couverture tout en n’apportant que peu de ce que l’automatisation promettait. Commencez par le taux d’instabilité à la première exécution et le ratio de maintenance de vos derniers sprints ; à eux deux, ils montrent où en est votre suite.
Si vous souhaitez qu’une équipe QA audite votre suite selon ces métriques, ou en construise une que vos ingénieurs continueront d’utiliser, parlez-en à QAwerk.
FAQ
Quelles sont les métriques d'automatisation des tests les plus importantes ?
Le taux de tests instables, le temps d’exécution de la suite, le ratio de maintenance et le taux de réussite à la première exécution suivi d’une version à l’autre, plus la couverture mesurée par rapport à vos parcours utilisateur critiques. Ensemble, ils montrent si la suite inspire confiance, si elle est assez rapide pour agir et si son entretien reste abordable. Le pourcentage de couverture brute est un contexte utile, mais un objectif faible à lui seul.
Qu'est-ce qu'un bon taux de tests instables ?
Il n’existe pas de référence universelle, car le taux dépend de la façon dont vous définissez la période et la suite. Une règle pratique consiste à traiter tout test qui change de résultat sur un commit inchangé comme un défaut, avec un responsable et une échéance, et à surveiller la tendance : un taux qui augmente d’une version à l’autre est le signal pour agir.
Comment mesurer le ROI de l'automatisation des tests ?
Comparez ce que coûtent l’exécution et la maintenance de la suite (temps d’exécution plus heures passées à réparer les tests) avec ce qu’elle remplace (le temps de régression manuelle) et ce qu’elle évite (les changements qui échouent en production). Suivre le ratio de maintenance et le taux d’échec des changements sur plusieurs versions donne une image plus honnête qu’une projection ponctuelle d’« heures économisées ».
La couverture des tests est-elle une métrique inutile ?
Non. La couverture montre quelle part du produit la suite touche, ce qui aide à repérer les zones non testées. Elle devient trompeuse quand elle est le seul objectif, car elle augmente aussi facilement avec des tests triviaux qu’avec des tests utiles. Mesurer la couverture par rapport à une liste de parcours critiques la garde utile.
Découvrez comment nous avons construit et maintenu plus de 1 100 cas de test pour Granola, un bloc-notes IA, et automatisé 76 % de sa suite de régression